Der Wettlauf um den kleinsten Transistor
14.09.2026
Warum Knotennamen wie „3 Nanometer“ längst Marketing sind, wie Intel seinen Vorsprung verlor und was nach dem Gate-All-Around-Transistor kommt.
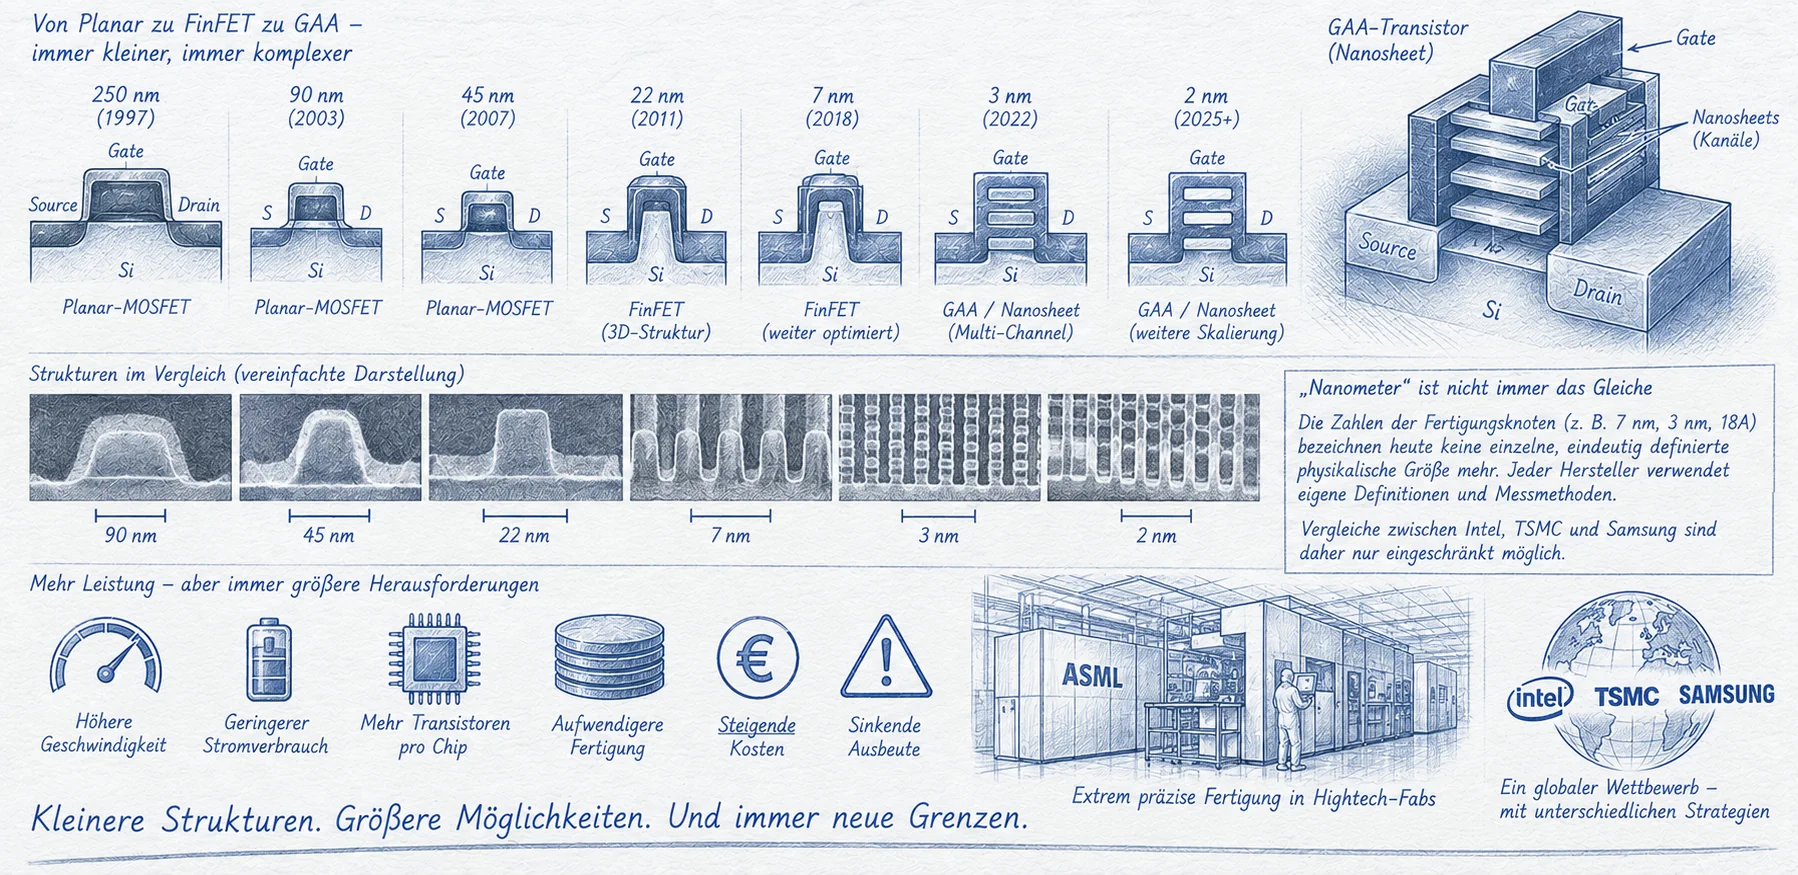
Bild: ChatGPT
Als Intel 2011 einen Transistor mit dreidimensionalem Kanal ankündigte, wirkte die Nachricht wie ein technischer Einschnitt. Jahrzehntelang hatte die Industrie versucht, mehr Transistoren unterzubringen, indem sie die Strukturen auf einer flachen Siliciumoberfläche verkleinerte. Nun erhob sich der Kanal als schmale Finne aus dem Substrat. Das Gate konnte ihn auf mehreren Seiten umgreifen und den Strom besser steuern. Aus einer Veränderung der Geometrie entstand die Grundlage für weitere Generationen hochintegrierter Prozessoren.
Heute sprechen Intel, TSMC und Samsung von Knoten wie „Intel 18A“, „N2“ oder „3 Nanometer“. Solche Namen klingen nach exakt messbaren Größen, sind jedoch keine einheitliche physikalische Definition der kleinsten Transistorstruktur. Entscheidend sind ebenso Transistorarchitektur, elektrische Eigenschaften, Verdrahtungsdichte, Ausbeute und Fertigungskosten. Der Wettlauf um den kleinsten Transistor wurde so zu einem Wettlauf um die gesamte Technologieplattform – und um die Fähigkeit, sie millionenfach zuverlässig herzustellen.
Von Mikrometern zu Nanometern: Als die Zahl noch näher an der Struktur lag
In den 1960er- und 1970er-Jahren wurden integrierte Schaltungen mit Strukturbreiten von mehreren Mikrometern gefertigt. Die Hersteller verbesserten Fotolithografie, Ätzverfahren, Oxidation und Dotierung, sodass die Abstände zwischen den Bauelementen kleiner wurden. Zunächst waren Transistoren noch weitgehend planar aufgebaut. Mit jeder Generation ließen sich mehr Funktionen auf derselben Waferfläche unterbringen, während die Schaltkapazitäten häufig sanken.
Bezeichnungen wie „1 µm“, „500 nm“ oder später „130 nm“ verwiesen historisch auf charakteristische Strukturmaße einer Prozessgeneration. Welche Größe tatsächlich namensgebend war, variierte jedoch im Lauf der Zeit und zwischen Speicher- und Logiktechnologien. Häufig wurden etwa Mindeststrukturbreiten, Gate-Längen oder die Hälfte eines besonders dichten Leitungsrasters betrachtet. Schon deshalb war eine Knotennummer nie eine vollständige Maßzeichnung des Transistors.
Wichtiger als ein einzelner Zahlenwert war die Fähigkeit, alle nötigen Strukturen gleichzeitig zu skalieren: Gateoxid, Kanal, Source- und Drain-Bereiche, Kontakte und Metallverbindungen. Eine kleinere Transistorgeometrie nützte wenig, wenn die Zuverlässigkeit schlechter wurde oder die Verdrahtung so viel Platz benötigte, dass die gewonnene Fläche wieder verloren ging.
Warum „7 Nanometer“ nicht sieben Nanometer bedeutet
Spätestens in den fortgeschrittenen Nanometer-Generationen entfernten sich Knotennamen deutlich von einer direkt messbaren Transistordimension. TSMCs „N7“, Samsungs „7LPP“ und Intels damaliges „10 nm“ bezeichneten jeweils eigene Technologieplattformen mit unterschiedlichen Zellbibliotheken, Abständen und Fertigungsverfahren. Es ist daher falsch anzunehmen, dass der Hersteller mit der kleinsten Zahl automatisch auch den kleinsten physikalischen Transistor fertigt.
2021 stellte Intel seine Benennung auf Intel 7, Intel 4 und Intel 3 sowie später auf die Ångström-Klasse mit Intel 18A um. Ein Ångström entspricht zwar 0,1 Nanometern, doch „18A“ ist kein Nachweis für eine Gate-Länge von 1,8 Nanometern. Auch TSMCs „N2“ bedeutet nicht, dass sämtliche funktionsbestimmenden Strukturen zwei Nanometer groß wären.
Ein seriöser Vergleich betrachtet mehrere Kennwerte: Transistordichte, Dichte konkreter Standardzellbibliotheken, SRAM-Fläche, maximale Geschwindigkeit bei festgelegter Versorgungsspannung, Energieverbrauch und Fertigungsausbeute. Selbst die Zahl „Millionen Transistoren pro Quadratmillimeter“ ist nur begrenzt vergleichbar, weil sich ein Logikbereich, ein SRAM-Block und ein analoges Schaltungsmodul in ihrer Dichte stark unterscheiden. Außerdem sind veröffentlichte Angaben oft unter unterschiedlichen Testbedingungen entstanden.
Der Aufstieg der Foundries verändert den Wettbewerb
Über Jahrzehnte fertigten Unternehmen wie Intel ihre selbst entwickelten Prozessoren in eigenen Fabriken. In der Foundry-Welt übernahm dagegen ein spezialisierter Auftragsfertiger die Produktion für viele unterschiedliche Kunden. Morris Chang gründete 1987 TSMC in Taiwan und machte dieses Geschäftsmodell zu einem eigenständigen industriellen Schwerpunkt. Chipentwickler konnten sich auf ihre Architektur konzentrieren, ohne selbst die Milliardenbeträge für eine moderne Fabrik aufbringen zu müssen.
Mit wachsendem Kundenkreis änderte sich die Finanzierung neuer Fertigungsknoten. TSMC konnte Prozessentwicklung, Anlagen und Produktionskapazität über Aufträge zahlreicher Chipdesigner auslasten. Namen wie Apple, AMD, NVIDIA und Qualcomm stehen für unterschiedliche Produktkategorien und hohe Stückzahlen. Große Ankerkunden erleichtern den Anlauf neuer Knoten, garantieren aber nicht allein deren Erfolg; der Prozess muss für viele Designs zuverlässig, wirtschaftlich und durch ein geeignetes Ökosystem von Entwurfswerkzeugen und IP-Blöcken nutzbar sein.
Samsung kombinierte weiterhin eigene Speicher- und Logikprodukte mit einem wachsenden Foundry-Geschäft. Intel wiederum versuchte in den 2020er-Jahren, neben seinen eigenen Prozessoren verstärkt Fertigungsleistungen für externe Kunden anzubieten. Damit wurde der Transistorwettlauf zugleich zum Wettbewerb verschiedener Geschäftsmodelle.
Intel: Vom Tick-Tock-Rhythmus zu den Schwierigkeiten mit 10 nm
Intel hatte in der PC-Ära einen besonders ausgeprägten Fertigungsrhythmus entwickelt. Beim sogenannten Tick-Tock-Modell wechselten neue Mikroarchitekturen und eine Verkleinerung der Prozesstechnik in ungefähr zweijährigen Entwicklungszyklen. Das Modell war kein mechanisch immer gleich eingehaltenes Gesetz, verlieh der Produktplanung aber lange eine erkennbare Struktur.
Beim eigenen 10-nm-Knoten geriet dieser Rhythmus ins Stocken. Intel verfolgte ehrgeizige Ziele bei der Packungsdichte und setzte auf komplizierte Mehrfachstrukturierung mit 193-nm-Immersionslithografie, unter anderem auf sehr anspruchsvolle Verfahren für feinste Strukturen. Die Kombination aus strengen Designregeln, Prozesskomplexität und Ausbeuteproblemen verzögerte die Einführung erheblich. Erste 10-nm-Produkte erschienen in begrenztem Umfang 2018; eine breitere Einführung erfolgte ab 2019 mit Ice Lake. Eine einzelne Jahreszahl als „Beginn der Serienfertigung“ würde diese schwierige Anlaufphase nur unzureichend beschreiben.
Inzwischen konnten Wettbewerber technologisch und wirtschaftlich aufholen. Die Verzögerung wirkte sich über mehrere Produktgenerationen aus, weil Prozessorarchitekturen, Fertigungskapazität und Markteinführungen eng miteinander verknüpft waren. Der Fall zeigte, dass extreme Strukturverkleinerung ohne verlässliche Massenproduktion keinen nachhaltigen Vorsprung ergibt.
2011/2012: Der FinFET verändert die Transistorform
Das Problem der planaren MOSFETs war zunehmend die elektrostatische Kontrolle des Kanals. Bei kurzen Kanälen konnten Drain- und Source-Potentiale die Sperrwirkung des Gates stärker beeinflussen. Leckströme und Kurzkanaleffekte machten die gewohnte Skalierung schwieriger. Forscher hatten dafür schon früher alternative Geometrien untersucht, darunter FinFET- und andere Mehrgatestrukturen.
Intel stellte 2011 seine 22-nm-Tri-Gate-Technologie vor und brachte sie 2012 in großen Stückzahlen in Prozessoren zum Einsatz. Der Kanal besteht aus einer dünnen, aus dem Substrat herausragenden Siliciumfinne. Das Gate umgreift die Finne von drei Seiten. Dadurch lassen sich die Ladungsträger im Kanal besser steuern, ohne ausschließlich auf eine immer dünnere Oxidschicht angewiesen zu sein.
TSMC und Samsung führten FinFET-Generationen in den folgenden Jahren für ihre leistungsfähigen Logikprozesse ein. Allerdings sind Struktur und Dimensionen einer FinFET-Zelle nicht nur vom Transistor abhängig: Finnenabstand, Kontaktierung, Gate-Raster und die verfügbare Verdrahtungsfläche bestimmen gemeinsam die Dichte. Der Transistor wurde dreidimensional, doch das Layout blieb eine ebenso wichtige Grenze der Integration.
2018 bis 2020: EUV wird aus einer Zukunftstechnologie ein Werkzeug
Als die Strukturen kleiner wurden, stießen auch die Lithografieverfahren an wirtschaftliche Grenzen. Mit 193-nm-Licht konnten Hersteller durch Immersion und Multiple Patterning noch wesentlich feinere Muster erzeugen. Dafür musste ein komplexes Layout aber in mehrere Teilmuster aufgespalten werden. Zusätzliche Masken, Prozessschritte und Ausrichtungsprüfungen erhöhten Zeit, Aufwand und potenzielle Fehlerquellen.
Ein bedeutender Meilenstein war TSMCs N7, der 2018 in die Großserienfertigung ging – zunächst noch ohne EUV-Belichtung. Erst die verbesserte Variante N7+ nutzte EUV für bestimmte Schichten und lieferte 2019 Produkte in großen Stückzahlen. Auch Samsung setzte EUV bei fortgeschrittenen Fertigungsknoten ein. Ab 2020 wurde EUV insbesondere mit TSMCs N5-Prozess zu einem wichtigen Bestandteil moderner Logikfertigung.
EUV allein machte keinen Knoten erfolgreich. Die Lichtquelle musste ausreichend leistungsfähig sein, die Maske und der Fotolack mussten zuverlässig arbeiten und die Prozessschritte mussten eine hohe Ausbeute erlauben. Zudem blieben DUV-Belichtungen für zahlreiche weniger kritische Schichten erhalten. Die Kombination beider Verfahren war wirtschaftlich sinnvoller als der Versuch, jeden einzelnen Schritt mit der neuesten Belichtungstechnik durchzuführen.
Warum ein neuer Knoten erst bei hoher Ausbeute wirklich zählt
Ein Chipdesign kann hervorragend sein und trotzdem zu teuer werden, wenn auf jedem Wafer zu viele Dies defekt sind. Die Ausbeute (Yield) beschreibt, wie viele der gefertigten Chips die erforderlichen Tests bestehen. Sie hängt von Partikeln, Materialdefekten, Prozessschwankungen, der Chipfläche und vielen elektrischen Randbedingungen ab. Gerade große Prozessoren mit vielen Funktionsblöcken reagieren empfindlich auf Fehler innerhalb der aktiven Chipfläche.
Ein neuer Prozess benötigt daher eine Phase des Yield Learning. Prozessingenieure identifizieren Fehlermuster, verbessern einzelne Anlagen und passen Prozessfenster an. Gleichzeitig überarbeiten Chipentwickler bei Bedarf bestimmte Layoutstrukturen, um empfindliche Stellen robuster zu machen. Das Zusammenspiel von Entwurf und Fertigung wird als Design-Technology Co-Optimization immer wichtiger.
Ein Hersteller kann die Einführung eines neuen Knotens öffentlich ankündigen, während anfänglich nur einzelne Kunden oder kleine Bausteine gefertigt werden. Ob daraus ein breit verwendbarer Prozess wird, zeigt sich erst an stabiler Produktion, verlässlicher Liefermenge und wirtschaftlichen Kosten pro funktionierendem Die. Exakte Yield-Zahlen einzelner Hersteller werden selten vollständig offengelegt; externe Schätzungen sind deshalb mit Vorsicht zu behandeln.
2022: Samsung bringt Gate-All-Around in die 3-nm-Klasse
Bei immer dünneren FinFET-Kanälen wächst die Schwierigkeit, das elektrische Feld vollständig unter Kontrolle zu halten. Eine Antwort ist Gate-All-Around (GAA). Hier umschließt das Gate den Kanal weitgehend von allen Seiten. Beim Nanosheet-Transistor bestehen die Kanäle aus mehreren übereinander angeordneten dünnen Siliciumschichten. Ihre Breite kann gezielt gewählt werden, um Ansteuerbarkeit, Leistung und Platzbedarf gegeneinander abzuwägen.
Samsung gab am 30. Juni 2022 den Produktionsbeginn seines GAA-basierten 3-nm-Prozesses bekannt. Die firmeneigene Bezeichnung MBCFET steht für Multi-Bridge-Channel Field-Effect Transistor. Damit erreichte eine neue Transistorarchitektur die kommerzielle Fertigung; die breite Anwendung in unterschiedlichen Hochvolumenprodukten ist davon allerdings zu unterscheiden.
Zu den Herausforderungen zählen die gleichmäßige Herstellung und Freilegung der dünnen Kanalschichten, die exakte Umhüllung durch das Gate sowie zuverlässige Kontakte und Metallverbindungen. Berichte über die Ausbeute früher GAA-Generationen zeigten, wie aufmerksam der Markt die Fertigungsreife beobachtete. Konkrete nicht öffentlich bestätigte Prozentwerte wären allerdings kein verlässlicher Maßstab für einen technischen Vergleich.
TSMC setzt länger auf FinFET – und wechselt dann zu Nanosheets
TSMC ging die Architekturumstellung anders an. Der Hersteller behielt für seine N3-Familie weiterhin FinFETs bei. Ende 2022 meldete TSMC den Beginn der 3-nm-Serienfertigung; in den Folgejahren entstanden mehrere optimierte Varianten mit unterschiedlichen Schwerpunkten bei Geschwindigkeit, Stromverbrauch, Kosten und Ausbeute. Der später erreichte große Fertigungsumfang zeigt, dass ein länger genutztes Transistorkonzept nicht automatisch technisch unterlegen ist.
Die nächste grundlegend neue Architektur folgte mit N2. Sie nutzt erstmals bei TSMC GAA-Nanosheet-Transistoren. Laut dem Geschäftsbericht 2025 begann die Großserienfertigung im vierten Quartal 2025; für 2026 erwartete TSMC einen weiteren Produktionshochlauf. Diese Entwicklung ist ein gutes Beispiel dafür, dass unterschiedliche Hersteller denselben Strukturwechsel zu verschiedenen Zeitpunkten vollziehen können.
Für die Zeit danach kündigte TSMC weitere Varianten wie N2P und A16 an. A16 soll Nanosheet-Transistoren mit rückseitiger Stromversorgung verbinden. Nach dem Ende 2025 veröffentlichten Zeitplan war die Serienfertigung für die zweite Hälfte 2026 vorgesehen. Ein geplanter Termin ist jedoch von einer bereits nachgewiesenen Produktion großer Stückzahlen zu unterscheiden.
Intel 18A: RibbonFET und die Stromversorgung von hinten
Als Reaktion auf die Verzögerungen bei früheren Knoten erneuerte Intel seine Prozessstrategie und benannte 2021 mehrere Generationen um. Zu den wichtigsten Neuerungen gehört Intel 18A, das Nanosheet- beziehungsweise RibbonFET-Transistoren mit einer neuen Anordnung der Stromversorgung verbindet. Die Grundidee von PowerVia besteht darin, die Versorgung stärker über Leitungen an der Waferrückseite bereitzustellen.
Bei herkömmlicher Verdrahtung müssen Stromversorgung und Signale auf den vorderen Metalllagen untergebracht werden. Rückseitige Stromzufuhr soll die Signalverdrahtung entlasten und Spannungsverluste reduzieren. Sie erfordert jedoch weitere anspruchsvolle Schritte, darunter das Bearbeiten der Waferrückseite und das Herstellen zuverlässiger elektrischer Verbindungen zu den Transistoren.
Anders als in älteren Roadmaps war 18A im Oktober 2026 nicht mehr nur ein Vorhaben. Intel bestätigte den Produktionsbeginn 2025; Panther-Lake-Prozessoren auf dieser Basis kamen Anfang 2026 auf den Markt. Im Juni 2026 berichtete das Unternehmen außerdem über die Risikofertigung der Weiterentwicklung 18A-P. Ob Intel sich mit diesen Verfahren dauerhaft als große Foundry für externe Kunden etabliert, ist eine wirtschaftliche Frage, die sich nicht allein aus der erfolgreichen Einführung eines eigenen Prozessors beantworten lässt.
Kleine Struktur, großer Aufwand: Die Kosten der nächsten Generation
Fortschritt bei der Transistordichte bedeutet nicht automatisch einen im gleichen Verhältnis sinkenden Preis pro Transistor. Moderne EUV-Belichtungssysteme, zusätzliche Prozessschritte, mehr Masken, komplexe Messverfahren und aufwendige Entwurfsregeln kosten viel Geld. Hinzu kommen die Entwicklung und Validierung von Standardzellbibliotheken, Speichern und Schnittstellen für jeden neuen Prozess.
Besonders schwierig ist, dass sich verschiedene Strukturen unterschiedlich gut verkleinern lassen. Eine einfache Logikzelle kann deutliche Flächengewinne erzielen, während SRAM-Blöcke weniger stark schrumpfen und analoge Schaltungen eigene Mindestabmessungen benötigen. Der Flächenbedarf eines realen Prozessors hängt daher stark von seinem Aufbau ab. Ein neuer Knoten kann beispielsweise bei Rechenlogik sehr attraktiv sein, ohne dass alle Bestandteile des Gesamtsystems im selben Maß profitieren.
Die Investitionen veränderten auch die Industrielandschaft: Der Kreis von Unternehmen, die modernste Logikprozesse entwickeln und produzieren können, ist kleiner geworden. Weltweit konzentrieren sich entsprechende Aktivitäten vor allem auf TSMC, Samsung und Intel, während zahlreiche andere Hersteller auf ausgereifte Technologien setzen. Das ist keine Rückständigkeit: Für Sensoren, Mikrocontroller, analoge Schaltungen und Leistungselektronik können ältere Prozesse technisch und wirtschaftlich die bessere Wahl sein.
Wie lassen sich Intel, TSMC und Samsung fair vergleichen?
Ein Vergleich allein nach der Knotennummer oder der ersten Ankündigung ist wenig aussagekräftig. Sinnvoller ist es, konkrete Eigenschaften zu untersuchen: Wie viele Standardzellen passen auf eine definierte Fläche? Wie schnell schalten sie bei einer vorgegebenen Spannung? Welche Verluste entstehen bei einem realistischen Produkt? Wie groß sind SRAM-Zellen, wie stabil ist die Fertigung und welche Preise entstehen pro gutem Chip?
Auch die Anwendung entscheidet. Ein Smartphone-Prozessor wird häufig nach besonders guter Energieeffizienz beurteilt; bei einem Rechenzentrumsbeschleuniger können Leistung, Speicheranbindung und Package-Fläche stärker gewichtet werden. Darüber hinaus sind die Werte aus unternehmenseigenen Präsentationen oft nicht nach einheitlichen Methoden gemessen. Eine pauschale Rangliste, die aus den Namen „2 nm“, „3 nm“ und „18A“ einen eindeutigen Sieger ableitet, würde deshalb mehr suggerieren, als die öffentlich verfügbaren Daten tatsächlich hergeben.
Die Entwicklung zeigt zudem, dass Fertigungsknoten und Chiparchitektur einander beeinflussen: Eine gut optimierte Architektur auf einer etwas älteren Prozessgeneration kann für eine konkrete Anwendung wirtschaftlicher oder leistungsfähiger sein als eine schwache Umsetzung auf der nominell kleinsten Technologie.
Nach Gate-All-Around: CFET und atomar dünne Kanäle
Als mögliche nächste Veränderung der Transistorstruktur wird der Complementary FET (CFET) erforscht. Bei heutigen CMOS-Standardzellen liegen n- und p-Kanaltransistoren im Wesentlichen nebeneinander. Ein CFET kann sie vertikal übereinander anordnen und damit die benötigte Grundfläche einer Logikfunktion verkleinern. Wie groß der Vorteil ausfällt, hängt von Kontakten, Isolationsabständen, Fertigbarkeit und Verdrahtung ab – die Packungsdichte verdoppelt sich nicht automatisch.
Forschungseinrichtungen wie imec untersuchen dazu monolithisch integrierte und sequenziell aufgebaute Strukturen. Parallel werden zweidimensionale Halbleitermaterialien wie Molybdändisulfid oder Wolframdisulfid erforscht. Ihre atomar dünnen Kanäle könnten die elektrostatische Kontrolle weiter verbessern, erfordern jedoch zuverlässige Herstellung, großflächige Materialqualität und Kontakte mit geringem Widerstand.
Solche Technologien sind langfristige Entwicklungsmöglichkeiten und keine Garantie für einen bestimmten industriellen Einführungstermin. Sie zeigen allerdings, dass Transistorskalierung inzwischen in mehreren Dimensionen gedacht wird: Kanalstruktur, vertikale Integration, Kontakte, Verdrahtung und Systemaufbau müssen gemeinsam verbessert werden.
Ein Wettlauf um ganze Fertigungssysteme
Der Wettlauf um den kleinsten Transistor begann als Wettbewerb um Strukturbreiten. Mit FinFET, GAA und rückseitiger Stromversorgung wurde daraus zunehmend ein Wettlauf um die Kontrolle elektrischer Felder, die Platzierung von Kontakten und die Nutzung jeder verfügbaren Fläche. Zugleich rückten Kosten, Ausbeute und die Skalierbarkeit der Fertigung stärker in den Mittelpunkt.
Dass TSMC seinen 3-nm-Prozess noch mit FinFETs produzierte, Samsung 2022 früh GAA einführte und Intel mit 18A ab 2025 GAA mit PowerVia kombinierte, zeigt verschiedene Wege zum selben Ziel. Keine dieser Entscheidungen lässt sich allein mit einer Zahl auf dem Knotenetikett bewerten. Erst wenn aus einem technischen Konzept zuverlässig produzierte Chips entstehen, wird aus Fortschritt ein industrieller Vorteil.
Der kleinste Transistor ist damit nicht mehr nur eine Frage der Nanometer. Er ist das Ergebnis des Zusammenspiels von Halbleiterphysik, Lithografie, Materialtechnik, Entwurfsautomatisierung und wirtschaftlicher Großserienfertigung – und genau das macht diesen Wettlauf zu einer der anspruchsvollsten Aufgaben der modernen Halbleiterindustrie.
Quellen und weiterführende Literatur
- Intel: Intel 4 Versus Intel 7 and Process Technology Naming (2025)
- Intel: Moore’s Law and Tri-Gate Transistors (2012)
- TSMC: Annual Report 2018 – N7 and N7+
- TSMC: N7+ Enters EUV High-Volume Production (2019)
- Samsung: Begins Production of 3 nm GAA Chips (2022)
- TSMC: Start of 3 nm Volume Production (2022)
- TSMC: Annual Report 2025 – N2, N2P and A16
- Intel: Panther Lake and Intel 18A (2025)
- Intel: Intel 18A-P Enters Risk Production (2026)