Warum gibt es eigentlich n- und p-Kanal?
14.09.2026
Elektronen und Löcher, Mobilitätsunterschiede zwischen NMOS und PMOS, und warum die CMOS-Inverter-Topologie zwingend beide Kanaltypen braucht.
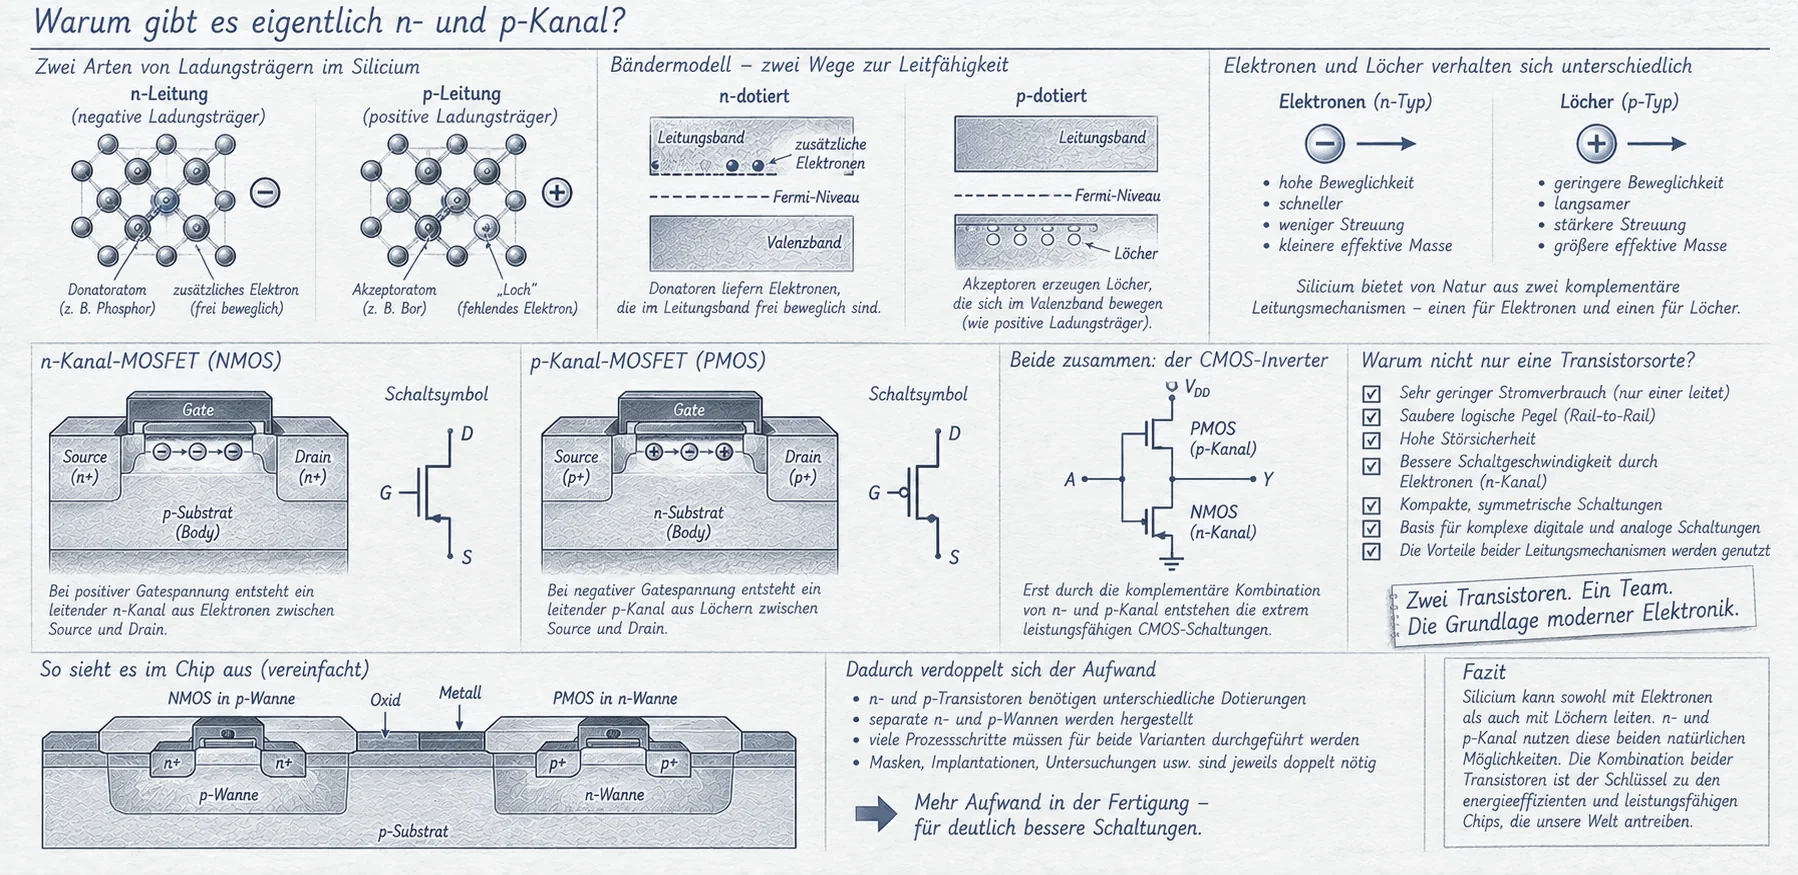
Bild: ChatGPT
Jeder moderne CMOS-Chip enthält zwei komplementäre Varianten des MOSFETs: n-Kanal- und p-Kanal-Transistoren. Die einen werden vor allem von Elektronen durchströmt, die anderen von sogenannten Löchern. Warum fertigt die Halbleiterindustrie beide auf demselben Wafer, obwohl Elektronen im Silicium beweglicher sind und n-Kanal-Transistoren häufig mehr Strom liefern? Die Antwort führt von der Dotierung über die Schwellenspannung bis zu einer der wichtigsten Schaltungsideen der Mikroelektronik: der komplementären MOS-Logik.
Zwei Ladungsträgerarten in einem Kristall
Reines Silicium besitzt bei Raumtemperatur nur eine vergleichsweise geringe Konzentration frei beweglicher Ladungsträger. Durch gezielte Dotierung lässt sich das ändern. Phosphor und andere fünfwertige Fremdatome stellen zusätzliche Elektronen bereit; in n-dotiertem Material sind Elektronen die Mehrheitsladungsträger. Bor und andere dreiwertige Fremdatome erzeugen dagegen leicht besetzbare Zustände im Valenzband. In p-dotiertem Material sind Löcher die Mehrheitsladungsträger.
Ein Loch ist keine positiv geladene Elementarteilchenart, sondern ein fehlendes Elektron im ansonsten besetzten Valenzband. Wenn Elektronen zwischen Bindungen wechseln, bewegt sich die freie Stelle effektiv in die Gegenrichtung. In elektrischen Rechnungen kann dieses Verhalten als Bewegung eines positiv geladenen Teilchens beschrieben werden. Beide Ladungsträgerarten existieren in einem Halbleiter grundsätzlich gleichzeitig; durch die Dotierung verschiebt sich vor allem ihr Mengenverhältnis.
Dotierung und Kanaltyp sind nicht dasselbe
Die Bezeichnungen n-Typ und p-Typ können sich auf das Ausgangsmaterial beziehen. Bei einem MOSFET meint n-Kanal beziehungsweise p-Kanal dagegen die beweglichen Ladungsträger im eingeschalteten Kanal zwischen Source und Drain. Das ist ein wichtiger Unterschied: Ein gewöhnlicher selbstsperrender NMOS-Transistor wird gerade in einem p-dotierten Bereich hergestellt, während ein entsprechender PMOS-Transistor einen n-dotierten Bereich benötigt.
Zwischen dem Gate und dem Silicium liegt eine dünne isolierende Schicht; moderne Bauelemente verwenden dafür oft komplexere Gate-Dielektrika als reines Siliciumdioxid. Die Spannung am Gate verändert das elektrische Potential unmittelbar darunter. Wird die notwendige Schwellenspannung überschritten, kann eine Inversionsschicht entstehen, in der der jeweils andere Ladungsträgertyp überwiegt. Diese leitfähige Schicht verbindet Source und Drain elektrisch, ohne dass das Gate einen dauerhaften Steuerstrom liefern muss.
Zwei Kanaltypen, entgegengesetzte Schaltpolarität
Bei einem selbstsperrenden NMOS bildet eine ausreichend positive Gate-Source-Spannung einen elektronenreichen Kanal in einem p-dotierten Gebiet. Beim ebenfalls selbstsperrenden PMOS entsteht der löcherreiche Kanal bei einer ausreichend negativen Gate-Source-Spannung im n-dotierten Gebiet. Entscheidend ist dabei die Spannung zwischen Gate und Source, nicht das Vorzeichen der Gate-Spannung gegenüber der Erde. Ein PMOS in einer Logikschaltung kann beispielsweise bei positivem Versorgungspotential betrieben werden und trotzdem einschalten, sobald sein Gate deutlich unter dem Source-Potential liegt.
NMOS und PMOS funktionieren also nach demselben elektrostatischen Grundprinzip, reagieren auf ihre Steuerspannung jedoch entgegengesetzt. Sie sind keine zwei völlig unterschiedlichen Erfindungen, sondern komplementäre Ausführungen des MOS-Feldeffekttransistors. Genau dieser Gegensatz ermöglicht den späteren Schaltungsvorteil.
Warum die Beweglichkeit den Unterschied macht
Elektronen und Löcher sind im Silicium nicht gleich beweglich. Bei vergleichbaren Bedingungen ist die Elektronenbeweglichkeit typischerweise etwa zwei- bis dreimal so hoch wie die Löcherbeweglichkeit. Das hängt mit der Bandstruktur, Streuprozessen und den effektiven Massen der Ladungsträger zusammen. Bei ansonsten vergleichbarer Geometrie kann ein NMOS deshalb häufig mehr Strom treiben und schneller schalten als ein PMOS.
Dieser Unterschied ist kein festes Geschwindigkeitsverhältnis für alle Transistoren. Die tatsächlich erreichbare Schaltgeschwindigkeit hängt auch von Gate-Kapazitäten, Versorgungsspannung, Kanallänge, Kontakten und der jeweiligen Prozesstechnologie ab. In vielen CMOS-Standardzellen wird der PMOS-Transistor breiter ausgelegt als sein NMOS-Gegenstück, damit beide ähnlich starke Ausgangstreiber bilden. Bei modernen FinFETs oder Gate-All-Around-Transistoren werden dafür andere Geometrie- und Materialparameter optimiert.
Warum nicht nur NMOS oder nur PMOS?
Reine NMOS- oder PMOS-Logik ist grundsätzlich möglich und wurde jahrzehntelang industriell eingesetzt. Ein NMOS-Transistor kann einen Ausgang sehr gut gegen Masse ziehen. Um den Ausgang anschließend wieder auf den hohen Spannungspegel zu bringen, wird jedoch ein geeignetes Lastelement benötigt – beispielsweise ein Widerstand oder ein als Last geschalteter weiterer MOSFET. Bei verbreiteten historischen Schaltungsvarianten entstand dadurch in einem stabilen Logikzustand ein dauerhafter Stromweg von der Versorgung nach Masse.
Bei einer überschaubaren Anzahl von Transistoren war dieser Verbrauch akzeptabel. Sobald tausende oder Millionen Gatter gemeinsam arbeiteten, wurde die Verlustleistung jedoch zum ernsthaften Problem. Für PMOS-Logik gilt das entsprechende Prinzip mit umgekehrten Polaritäten. Warum zuerst PMOS und später NMOS große Bedeutung gewann, lag zusätzlich an der Fertigung: In den 1960er-Jahren erschwerten bewegliche Natrium-Ionen und instabile Oxidladungen die Herstellung zuverlässiger NMOS-Bauelemente. Bessere Oxide, reinere Prozesse und kontrollierte Schwellenspannungen beseitigten diese Schwierigkeiten schrittweise.
1963: Wanlass und Sah nutzen die Komplementarität
Den entscheidenden Schaltungsgedanken stellten Frank Wanlass und Chih-Tang Sah von Fairchild Semiconductor 1963 auf der International Solid-State Circuits Conference vor. Sie kombinierten p-Kanal- und n-Kanal-MOSFETs so, dass sich die beiden Transistoren in stabilen Schaltzuständen gegenseitig ergänzen. Wanlass meldete im selben Jahr ein Patent für eine solche besonders stromsparende Schaltung an. Der Name CMOS steht für Complementary Metal-Oxide-Semiconductor.
Der Vorteil war zunächst keineswegs überall überzeugend. Beide Transistortypen gemeinsam zuverlässig zu fertigen war aufwendiger, und frühe CMOS-Schaltungen waren häufig langsamer als konkurrierende bipolare oder NMOS-Logik. RCA entwickelte die Technik unter der Bezeichnung COS/MOS zu einer industriell einsetzbaren Logikfamilie weiter. Besonders für batterieversorgte Geräte, Uhren und Systeme mit begrenzter Energieversorgung war der geringe Ruhestrom attraktiv. Erst mit verbesserter Fertigung und höherer Integrationsdichte setzte sich CMOS in breiterem Umfang durch.
Warum CMOS beide Typen braucht: Der Inverter
Der einfachste CMOS-Logikbaustein ist der Inverter, also ein Gatter, das aus einer logischen Null eine Eins und aus einer Eins eine Null macht. Er besteht aus einem PMOS und einem NMOS. Der PMOS verbindet den Ausgang mit der positiven Versorgungsspannung, der NMOS mit Masse. Beide Gate-Anschlüsse liegen gemeinsam am Eingang.
Bei niedrigem Eingangspotential leitet der PMOS, der NMOS sperrt und der Ausgang wird nach oben gezogen (Pull-up, kurz PU). Bei hohem Eingangspotential sperrt der PMOS, während der NMOS leitet und den Ausgang nach unten zieht (Pull-down, kurz PD). In beiden stabilen Zuständen unterbricht einer der beiden Transistoren den direkten Leitungsweg zwischen Versorgung und Masse. Anders als bei vielen historischen Ein-Kanal-Logiken wird daher kein dauernd leitendes Lastelement für den jeweils entgegengesetzten Pegel benötigt.
Das Prinzip gilt nicht nur für Inverter. In einem statischen CMOS-NAND-Gatter stehen beispielsweise zwei PMOS-Transistoren parallel im Pull-up-Netzwerk und zwei NMOS-Transistoren in Reihe im Pull-down-Netzwerk. Entsprechend spiegelbildliche Anordnungen ergeben NOR und weitere Logikfunktionen. Die komplementären Netzwerke sorgen dafür, dass im gültigen stabilen Logikzustand jeweils nur der Weg zur passenden Versorgungsschiene leitend sein soll.
Warum CMOS nicht völlig stromlos ist
Der geringe Ruhestrom bedeutet nicht, dass ein CMOS-Prozessor keinen Strom verbraucht. Beim Umschalten müssen die Gate- und Leitungs-Kapazitäten aufgeladen oder entladen werden. Für einen Teil der Schaltbewegung können außerdem kurzzeitig beide Transistoren Strom leiten. Diese dynamische Leistungsaufnahme steigt unter anderem mit Schaltaktivität, Kapazität, Taktfrequenz und ungefähr mit dem Quadrat der Versorgungsspannung.
Auch im Ruhezustand fließen kleine Leckströme: etwa durch schwach leitende gesperrte Transistoren, pn-Übergänge und unter bestimmten Bedingungen durch Gate-Isolatoren. Bei sehr kleinen Strukturen können diese Verluste erheblich werden. Der historische Vorteil von CMOS besteht also nicht in einer vollkommen stromlosen Elektronik, sondern darin, dass es den dauerhaften Gleichstrompfad der älteren widerstands- oder transistorbelasteten Logik weitgehend vermeidet.
Der Fertigungsaufwand: Wannen, Isolation und Latch-up
Damit NMOS und PMOS auf demselben Wafer arbeiten können, benötigen sie passend dotierte Körperbereiche. Bei einer klassischen n-Wannen-Technologie liegen NMOS-Transistoren beispielsweise im p-dotierten Substrat, während PMOS-Transistoren in eigens eingebrachten n-Wannen hergestellt werden. Andere Prozesse verwenden p-Wannen oder beide Wannentypen. Zusätzliche Implantations-, Masken- und Isolationsschritte sind dafür nötig. Es verdoppelt jedoch nicht einfach jeden Schritt der Fertigung.
Die leitenden Bereiche müssen zuverlässig voneinander getrennt und die Körperanschlüsse an definierte Potentiale angebunden werden. Ein weiterer Grund dafür ist Latch-up: Durch parasitäre Bipolartransistoren im Silicium kann ungewollt eine thyristorähnliche Struktur entstehen, die einen starken Strom zwischen den Versorgungsschienen führt. Well-Kontakte, geeignete Abstände, Guard-Rings und andere Prozess- und Layoutmaßnahmen vermindern dieses Risiko.
Der zusätzliche Fertigungsaufwand lohnt sich, weil die komplementäre Schaltungstechnik den Stromverbrauch bei einer großen Zahl digitaler Gatter drastisch reduzieren kann. Die genaue Ausführung hat sich mit planaren MOSFETs, FinFETs und modernen Gate-All-Around-Strukturen weiterentwickelt, doch der elektrische Gegensatz zwischen n- und p-Kanal bleibt erhalten.
Zwei Kanaltypen, eine gemeinsame Stärke
Silicium stellt mit Elektronen und Löchern zwei Arten beweglicher Ladungsträger bereit. Der NMOS nutzt den einen Typ für einen gut steuerbaren Weg nach Masse, der PMOS den anderen für den Weg zur Versorgung. Einzelne n-Kanal-Transistoren bieten häufig Vorteile bei Strom und Geschwindigkeit; als komplementäres Paar ermöglichen beide jedoch besonders energieeffiziente Digitalgatter.
Die Leistung der CMOS-Idee bestand deshalb nicht darin, n- und p-Leitung überhaupt erst zu entdecken. Entscheidend war die Erkenntnis, ihre entgegengesetzten Schalteigenschaften zu einer gemeinsamen Schaltung zusammenzufügen. Genau diese Kombination macht aus zwei unterschiedlichen Transistoren die Grundlage moderner digitaler Mikroelektronik.
Quellen und weiterführende Literatur
- Computer History Museum: Complementary MOS Circuit Configuration is Invented (1963)
- Frank Wanlass: Low Stand-By Power Complementary Field Effect Circuitry, US-Patent 3,356,858 (angemeldet 1963)
- MIT OpenCourseWare: Analysis and Design of Digital Integrated Circuits – CMOS-Inverter und Leistungsaufnahme
- NASA: Reducing Sodium Contamination in MOS Devices (1986)
- TU Dortmund: Rechnerarchitektur – statische und dynamische CMOS-Leistungsaufnahme