Moores Gesetz – und warum es immer schwieriger wird
14.09.2026
Dennard Scaling, die Power Wall, FinFET und GAAFET – warum jede Dekade eine komplett neue physikalische Erfindung brauchte, um Moores Gesetz am Leben zu halten.
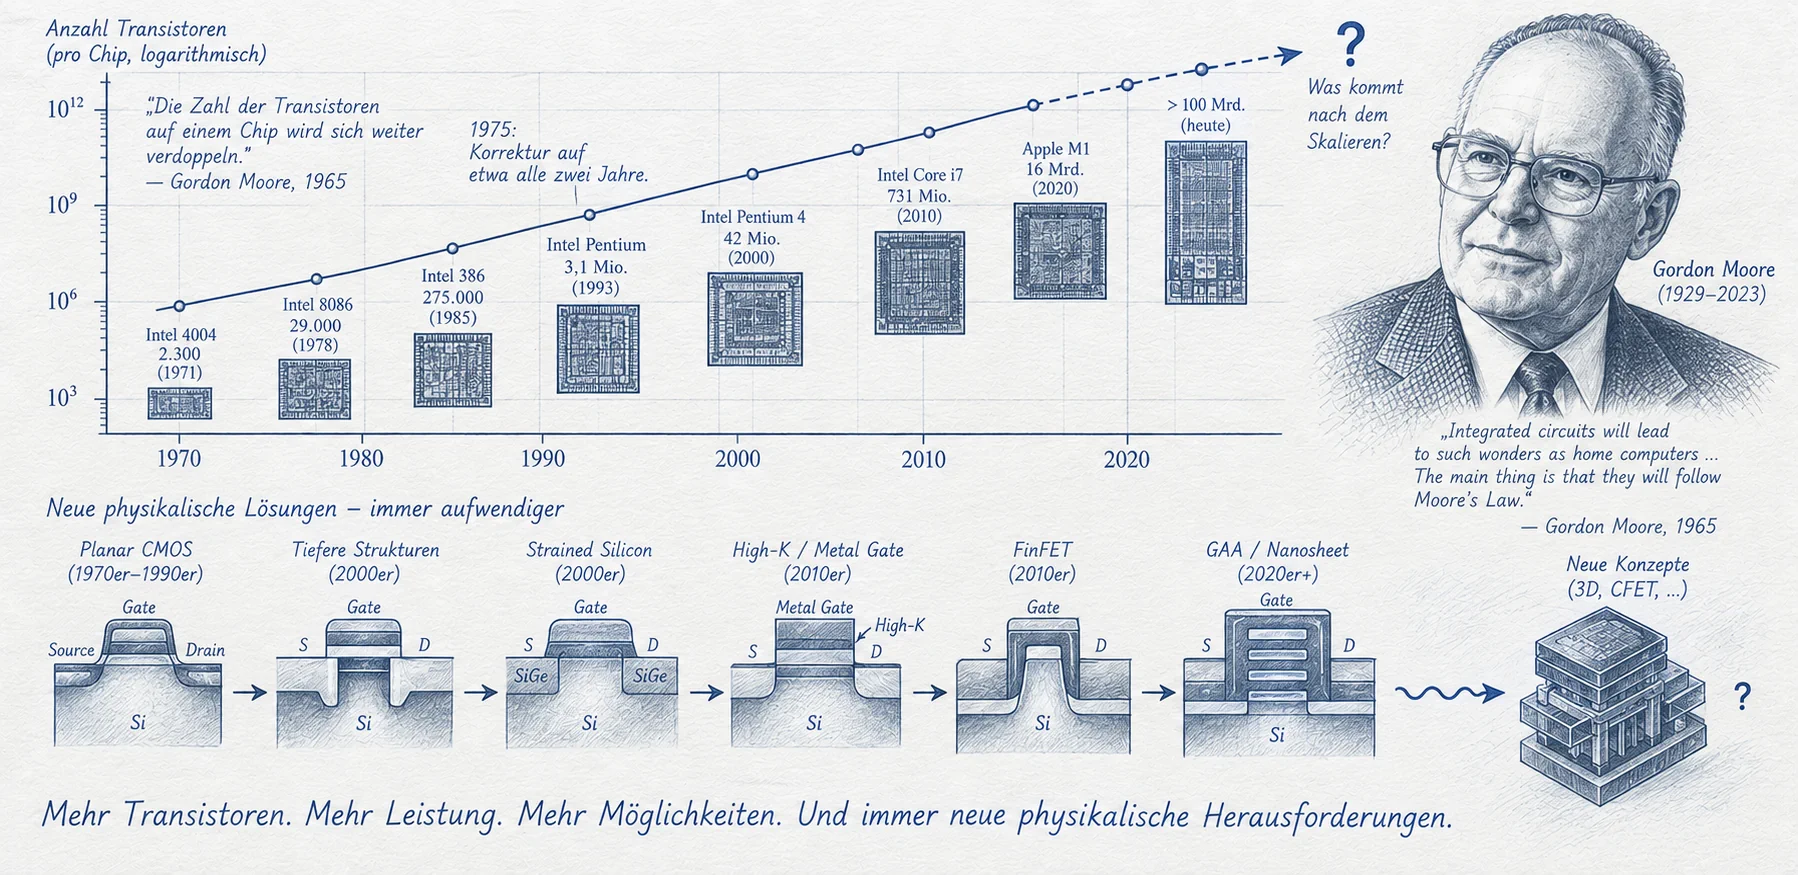
Bild: ChatGPT
1965 erkannte Gordon Moore bei Fairchild Semiconductor eine auffällige Entwicklung: Die wirtschaftlich günstigste Zahl von Bauelementen auf einem integrierten Schaltkreis war in den vergangenen Jahren rasant gestiegen. Zehn Jahre später korrigierte er die beobachtete Verdopplungsrate von einem auf etwa zwei Jahre. Aus dieser Prognose wurde eines der bekanntesten „Gesetze“ der Technikgeschichte – obwohl es keine physikalische Gesetzmäßigkeit beschreibt.
Sein langes Fortbestehen war nur möglich, weil sich Herstellungsverfahren, Transistorarchitekturen, Materialien und Entwurfswerkzeuge immer wieder grundlegend veränderten. Doch die Entwicklung hatte einen Preis: Seit der Mitte der 2000er-Jahre steigen Transistorzahl, Rechenleistung und Wirtschaftlichkeit nicht mehr automatisch gemeinsam. Was genau sagte Moore ursprünglich voraus, und warum fällt die Fortsetzung seiner Kurve heute so schwer?
1965: Eine Beobachtung über den Preis eines Bauelements
Im Frühjahr 1965 arbeitete Gordon E. Moore als Forschungsleiter bei Fairchild Semiconductor. Die integrierte Schaltung war noch jung; viele Produkte enthielten wenige Dutzend Bauelemente. Moore sollte für die Zeitschrift Electronics beschreiben, wie sich die Technik in den kommenden Jahren entwickeln könnte. In seinem Artikel vom 19. April 1965, Cramming more components onto integrated circuits, betrachtete er nicht einfach die größtmögliche Transistorzahl. Er fragte nach der Anzahl von Bauelementen, bei der ein Chip am wirtschaftlichsten herzustellen war.
Bei zu geringer Integration verteilen sich Gehäuse- und Fertigungskosten auf nur wenige Funktionen. Wird der Chip dagegen zu groß, steigen die Fehlerwahrscheinlichkeit und die Kosten pro fehlerfreiem Bauelement. Zwischen beiden Extremen liegt ein Kostenminimum. Moore beobachtete, dass sich die Zahl der Bauelemente in diesem wirtschaftlich günstigen Bereich bis dahin etwa jährlich verdoppelt hatte. Er zeichnete die wenigen verfügbaren Datenpunkte in ein Diagramm und extrapolierte sie: Bis 1975 könnten etwa 65.000 Bauelemente auf einem integrierten Schaltkreis wirtschaftlich sinnvoll sein. Diese Prognose war erstaunlich kühn – und doch keine Naturkonstante.
1975: Aus einem Jahr werden zwei
Moores Aussage wurde schnell als Prognose über den technischen Fortschritt verstanden. Tatsächlich änderte er sie selbst. Bei einer Fachkonferenz des IEEE im Jahr 1975 zeigte er, dass sich seine zehn Jahre alte Voraussage erstaunlich gut bewährt hatte. Gleichzeitig erkannte er, dass sich die Steigerungsrate langfristig verlangsamen würde. Statt einer jährlichen Verdopplung erwartete er nun etwa eine Verdopplung alle zwei Jahre.
Die oft zitierte Variante von 18 Monaten ist nicht Moores ursprüngliche Formulierung. Sie entstand aus späteren Interpretationen und wurde häufig mit der Entwicklung der Rechenleistung verbunden. Doch Transistorzahl, Taktfrequenz, Verarbeitungsgeschwindigkeit und Kosten pro Funktion sind verschiedene Kenngrößen. Ein Prozessor mit doppelt so vielen Transistoren rechnet nicht automatisch doppelt so schnell. Zusätzliche Bauelemente können ebenso für größere Caches, mehrere Prozessorkerne oder spezialisierte Beschleuniger verwendet werden.
Das sogenannte Gesetz wurde mit der Zeit zugleich zur industriellen Zielvorgabe: Halbleiterhersteller, Anlagenlieferanten und Entwickler planten ihre Technologiegenerationen daran aus. Aus einer Beobachtung entstand eine Erwartung, an der sich Forschung, Investitionen und Wettbewerb orientierten.
Der stille Partner: Dennard Scaling
Über viele Jahrzehnte brachte eine kleinere Transistorstruktur nicht nur mehr Bauelemente pro Chip, sondern auch höhere Geschwindigkeit und geringeren Energiebedarf je Schaltvorgang. Dahinter steckte eine zweite, eigenständige Entwicklung: das nach IBM-Forscher Robert Dennard benannte Skalierungsprinzip. Dennard und seine Mitautoren beschrieben 1974, wie sich die Abmessungen eines MOSFETs gemeinsam mit Versorgungsspannung und weiteren elektrischen Größen verkleinern lassen.
Im idealisierten Constant-Field-Scaling werden beispielsweise sämtliche Längen um den Faktor zwei und die Spannungen ebenfalls etwa halbiert. Dann bleibt das elektrische Feld in wichtigen Bereichen näherungsweise konstant. Die Fläche eines Transistors sinkt auf ein Viertel; seine Kapazität und die Energie eines Schaltvorgangs können deutlich abnehmen. Bei geeigneter Anpassung der weiteren Parameter kann die Leistungsdichte ungefähr konstant bleiben, während viel mehr Bauelemente auf derselben Fläche arbeiten.
Diese Regeln waren kein automatisches Versprechen: Reale Materialien, Kontakte und Verbindungen folgten ihnen nie vollkommen. Für die Entwicklung der Mikroprozessoren waren sie dennoch außerordentlich wichtig. Sie erklärten, weshalb Transistorverkleinerung lange Zeit gleichzeitig höhere Integrationsdichte, steigende Taktraten und beherrschbare Kühlung ermöglichte.
Warum kleinere Chips zunächst günstiger wurden
Die physikalische Verkleinerung war stets mit einer wirtschaftlichen Entwicklung verbunden. Auf einem Siliciumwafer werden viele Chips parallel gefertigt. Wenn eine neue Technologie die gleiche Funktion auf kleinerer Fläche unterbringt, passen grundsätzlich mehr Exemplare auf denselben Wafer. Das kann die Kosten pro Bauelement senken und eröffnet zugleich Platz für zusätzliche Funktionen. Kleinere Transistoren erleichterten deshalb erschwingliche Taschenrechner, Heimcomputer, Smartphones und zahlreiche Geräte, die zuvor zu groß oder zu teuer gewesen wären.
Der Nutzen hängt aber von der Ausbeute ab. Ein größerer Chip enthält mehr Fläche, auf der Defekte auftreten können, und nicht jeder gefertigte Die funktioniert. Auch Waferdurchmesser, Maschinenkapazität, Maskenkosten und Prozesszeit beeinflussen die Rechnung. Besonders bei Speicherchips, deren Zellen millionenfach in regelmäßigen Mustern vorkommen, ließ sich die Skalierung sehr effektiv ausnutzen. Komplexe Logikschaltungen weisen andere Flächenanteile und Verdrahtungsprobleme auf.
Damit Moores wirtschaftliches Versprechen wirkte, mussten die Hersteller also nicht nur Strukturen verkleinern. Sie mussten die Prozesse beherrschen, die Fehlerzahlen niedrig halten und eine wachsende Produktionsmenge erreichen. Fortschritte in Lithografie, Reinraumtechnik, Prozesskontrolle und Automatisierung waren dabei ebenso wichtig wie die eigentliche Transistorphysik.
Warum dieser Mechanismus zerbrach
Um die Jahrtausendwende stieß das gemeinsame Verkleinern von Geometrie und Spannung zunehmend an Grenzen. Die Schwellenspannung eines gewöhnlichen MOSFETs lässt sich nicht unbegrenzt senken, ohne den Leckstrom im ausgeschalteten Zustand ansteigen zu lassen. Für einen idealen MOSFET gilt bei Raumtemperatur ein thermisch bedingtes Maß von ungefähr 60 Millivolt pro Dekade für die Steilheit des Unterschwellenstroms. Dies ist keine absolute Untergrenze für jede denkbare Transistorart, aber eine grundlegende Beschränkung klassischer thermisch betriebener MOSFETs.
Außerdem war die Siliciumdioxidschicht unter dem Gate immer dünner geworden. Bei Dicken von nur wenigen Atomlagen konnten Elektronen durch die Isolationsbarriere tunneln. Gate-Leckströme und die damit verbundenen Energieverluste nahmen zu. Gleichzeitig ließen sich Versorgungsspannungen nicht in demselben Tempo wie die Strukturbreiten reduzieren.
In den frühen bis mittleren 2000er-Jahren endete deshalb die lange Phase, in der schnellere Transistoren und mehr Transistoren fast selbstverständlich mit ähnlicher Leistungsdichte einhergingen. Dies wird häufig als Ende des klassischen Dennard Scaling bezeichnet. Die Transistorzahl konnte weiter steigen – die gesamte Schaltung durfte aber nicht mehr beliebig schneller oder gleichzeitig aktiv werden.
Neue Materialien retten das Gate: High-k und Metall-Gate
Eine der wirksamsten Gegenmaßnahmen betraf die Gate-Isolation. Das Siliciumdioxid sollte einerseits dünn sein, damit das elektrische Feld den Kanal gut steuern kann, andererseits dick genug, um Tunnelströme zu unterdrücken. Mit herkömmlichem SiO2 gerieten diese Anforderungen zunehmend in Konflikt. Forschung und Industrie entwickelten daher die Kombination aus einem dielektrischen Material mit hoher relativer Permittivität, einem High-k-Dielektrikum, und einem passenden Metall-Gate.
Hafniumbasierte Materialien ermöglichen bei größerer physischer Schichtdicke eine elektrische Gate-Kopplung, die einer viel dünneren Oxidschicht entspricht. Die höhere Dicke reduziert die Tunnelwahrscheinlichkeit. Zugleich vermeidet das Metall-Gate bestimmte Nachteile des zuvor verwendeten dotierten Polysiliciums und unterstützt die Einstellung geeigneter Schwellenspannungen.
Intel führte 2007 bei seiner 45-nm-Generation Prozessoren mit High-k/Metal-Gate ein; die Serienfertigung begann im selben Jahr. Weitere Hersteller übernahmen verwandte Ansätze. Zuvor hatte die Industrie bereits verspannte Siliciumkanäle genutzt, um die Beweglichkeit von Elektronen und Löchern zu verbessern. Beides zeigt: Die Weiterentwicklung des Transistors beruhte nicht mehr allein auf einer verkleinerten geometrischen Zeichnung, sondern zunehmend auf gezieltem Material- und Strukturengineering.
Kurzkanaleffekte zwingen zu neuer Geometrie
Parallel zu den Leckströmen im Gate entwickelte sich ein zweites Problem: Wenn der Kanal zwischen Source und Drain immer kürzer wird, verliert das Gate eines flachen MOSFETs einen Teil seiner Kontrolle. Das elektrische Feld des Drain kann die Potentialbarriere am Source verändern. Dieser Drain-Induced Barrier Lowering (DIBL) genannte Effekt erhöht den unerwünschten Strom im ausgeschalteten Zustand.
Ingenieure versuchten, die Probleme durch flachere Dotierungsprofile, Halostrukturen, gezieltes Verspannen des Kristallgitters und verbesserte Gate-Dielektrika zu begrenzen. Solche Maßnahmen machten neue Fertigungsschritte erforderlich: zusätzliche Implantationen, anspruchsvolle Wärmebehandlungen und eine präzisere Kontrolle nanometergroßer Strukturen. Der flache MOSFET ließ sich damit noch mehrere Generationen weiterentwickeln, doch die Entwurfsfreiheit wurde immer geringer.
Am Ende reichte es nicht, den Kanal weiter zu verkürzen. Die elektrische Kontrolle musste auch geometrisch verbessert werden: Das Gate sollte den leitenden Kanal nicht mehr nur von oben beeinflussen, sondern möglichst von mehreren Seiten umschließen.
Der Transistor stellt sich auf: FinFET und Tri-Gate
Die Idee eines dreidimensionalen Gates wurde lange vor ihrer großflächigen Fertigung erforscht. Ende der 1990er-Jahre entwickelte eine Gruppe um Chenming Hu an der University of California, Berkeley, eine besonders einflussreiche FinFET-Struktur. Der Kanal bildet dabei eine dünne Silicium-Finne, die senkrecht aus dem Substrat herausragt. Das Gate liegt auf beiden Seiten und bei geeigneter Ausführung auch über der Oberseite der Finne. So kann es den Kanal wesentlich besser kontrollieren als bei einem planaren Aufbau.
Intel stellte 2011 seine 22-nm-Tri-Gate-Transistoren vor und brachte sie 2012 in die Großserienfertigung. In den folgenden Jahren wurden FinFETs auch bei anderen Herstellern zum Standard für fortschrittliche Logiktechnologien. Die dreidimensionale Geometrie reduzierte die Kurzkanalprobleme und erlaubte eine günstigere Kombination aus Schaltgeschwindigkeit und Leckstrom.
Der Wechsel erforderte tiefgreifende Änderungen der Fertigung. Finnen mussten mit sehr geringen Toleranzen strukturiert werden; ihre Höhe, Breite und die Gate-Umhüllung bestimmten die elektrischen Eigenschaften. Die Technologie zeigt anschaulich, wie aus einer Skalierungsregel ein industrieller Wettlauf um neue Bauelementarchitekturen wurde.
Wenn selbst die Finne nicht mehr reicht: Gate-All-Around
Auch die FinFET-Geometrie besitzt Grenzen. Sehr schmale Finnen bieten wenig leitenden Querschnitt, während immer dichtere Strukturen große Anforderungen an Ätzprozesse, Kontakte und Variationskontrolle stellen. Ein weiterer Schritt besteht darin, den Kanal auf allen Seiten mit dem Gate zu umgeben. Beim Gate-All-Around-FET (GAAFET) kann der Kanal als Nanodraht oder als mehrere übereinanderliegende Nanosheets ausgeführt sein.
Bei Nanosheet-Transistoren werden dünne, horizontale Siliciumschichten freigelegt und danach vollständig von Gate-Material umhüllt. Ihre Breite lässt sich innerhalb bestimmter Prozessgrenzen variieren, um den gewünschten Transistorstrom einzustellen. Das steigert die Freiheitsgrade, macht aber selektive Ätzschritte, die Isolierung der Schichten und die Kontaktierung komplizierter.
Samsung meldete im Juni 2022 den Beginn einer 3-nm-Prozessfertigung mit GAA-Nanosheets. TSMC nahm laut eigenem Geschäftsbericht die 2-nm-Serienfertigung mit Nanosheet-Transistoren im vierten Quartal 2025 auf. Die Bezeichnungen „3 nm“ und „2 nm“ sind dabei Technologienamen; sie entsprechen nicht einer einheitlichen physischen Gatelänge aller Transistoren.
Warum ohne EUV vieles teurer geworden wäre
Während die Bauelementarchitektur immer komplizierter wurde, erreichte auch die Lithografie wirtschaftliche Grenzen. Mit 193-nm-ArF-Immersionslithografie lassen sich zwar Strukturen wesentlich kleiner als die Wellenlänge erzeugen, doch dazu werden Auflösungsverbesserungen und bei sehr feinen Mustern mehrere Masken- und Strukturierungsschritte benötigt. Dieses Multiple Patterning erhöht Prozesszeit, Maskenkosten, Überlagerungsanforderungen und Fehlerrisiken.
Die EUV-Lithografie verwendet Licht mit 13,5 nm Wellenlänge und erlaubt es, bestimmte kritische Muster mit weniger Mehrfachstrukturierung herzustellen. Nach jahrzehntelanger Entwicklung zog EUV um 2019 in die industrielle Großserienfertigung ein. Die Anlagen sind hochkomplex: Das Licht entsteht aus einem Plasma, der Strahl wird über Spiegel geführt, und Masken wie Fotolack müssen besonders strenge Anforderungen erfüllen.
EUV beseitigt das Multiple Patterning allerdings nicht vollständig. Einige Muster erfordern weiterhin zusätzliche Schritte; andere Lagen werden auch in modernen Technologien wirtschaftlich mit DUV belichtet. EUV war somit kein einfacher Ersatz für alle bisherigen Verfahren, sondern eine zusätzliche Werkzeugklasse, ohne die viele führende Prozesse erheblich aufwendiger geworden wären.
Was „7 nm“ oder „2 nm“ heute tatsächlich bedeutet
In frühen Technologiegenerationen hatten Angaben wie „1 µm“ oder „350 nm“ noch einen relativ direkten Bezug zu charakteristischen Bauteilabmessungen. Später änderte sich diese Praxis. Heutige Prozessbezeichnungen wie 7 nm, 5 nm oder 2 nm bezeichnen ganze Technologieplattformen mit bestimmten Transistoren, Metalllagen, Bibliotheken und Fertigungsregeln. Sie sind weder eine einzelne, universell definierte Abmessung noch unmittelbar zwischen allen Herstellern vergleichbar.
Ein kleinerer Technologieknoten bedeutet deshalb nicht automatisch, dass jede Leitung, jede Speicherzelle und jede Schaltung proportional schrumpft. SRAM-Bit-Zellen, Logikzellen, Analogtransistoren und die Verdrahtung folgen unterschiedlichen Randbedingungen. Manche Funktionen gewinnen stark an Dichte, andere weniger. Um reale Fortschritte zu beurteilen, muss man sowohl die Packungsdichte als auch Geschwindigkeit, Leistungsaufnahme, Ausbeute und Kosten betrachten.
Diese Unterscheidung ist wichtig, weil Moores Gesetz heute oft mit den Namen der Fertigungsprozesse gleichgesetzt wird. Ein neuer Knoten kann bedeutende Verbesserungen bringen, ohne dass die ursprüngliche Kostenkurve automatisch im gleichen Tempo weiterläuft.
Die wirtschaftliche Grenze: Mehr Transistoren, aber zu welchem Preis?
Moores ursprüngliche Beobachtung war eng mit den Kosten pro Bauelement verbunden. Gerade dieser Teil wird zunehmend anspruchsvoll. Neue Fabriken kosten zweistellige Milliardenbeträge, moderne Lithografiesysteme sind sehr teuer und die Zahl der Fertigungsschritte nimmt zu. Maskensätze, Entwicklung, Verifikation und die Anpassung des Chipdesigns an einen neuen Prozess verursachen ebenfalls hohe Einmalkosten.
Für Hersteller großer Stückzahlen kann sich der Umstieg dennoch lohnen: Höhere Dichte und Leistungsfähigkeit verteilen die Investitionen auf viele verkaufte Chips. Bei spezialisierten Produkten, kleineren Stückzahlen oder analogen Funktionen ist ein bewährter Fertigungsknoten wirtschaftlich oft sinnvoller. Die Halbleiterbranche verwendet deshalb gleichzeitig zahlreiche Prozessgenerationen.
Aus größerer Transistordichte folgt heute nicht zwangsläufig ein niedrigerer Preis pro Transistor. Der Kostenvorteil hängt unter anderem von der erreichbaren Ausbeute, dem Schaltungsaufbau und den benötigten Fertigungsschritten ab. Ein Chip kann deutlich leistungsfähiger werden und dennoch teurer in der Herstellung sein. Das ist ein wesentlicher Unterschied zwischen dem ursprünglichen ökonomischen Kern von Moores Beobachtung und ihrer populären Reduktion auf die reine Transistorzahl.
Der Leistungsverbrauch stoppt die Taktjagd
Bis in die frühen 2000er-Jahre gehörten deutlich steigende Taktfrequenzen zu den sichtbarsten Fortschritten von Prozessoren. Als sich die Versorgungsspannung nicht mehr ausreichend senken ließ, wurden höhere Frequenzen zunehmend durch stark steigende dynamische Leistungsaufnahme und Wärmeentwicklung begrenzt. Eine vereinfachte Näherung lautet P ≈ α · C · V² · f: Die dynamische Leistung hängt von Aktivitätsfaktor, geschalteter Kapazität, Quadrat der Versorgungsspannung und Taktfrequenz ab.
Die Industrie verlagerte deshalb ihren Schwerpunkt auf Mehrkernprozessoren, größere Caches, effizientere Architekturen und spezialisierte Beschleuniger. Zusätzliche Transistoren liefern heute häufig mehr parallele Rechenleistung, bessere Energieeffizienz oder größere Datenspeicher, statt nur den Takt eines einzelnen Kerns zu erhöhen.
Manche Funktionen eines modernen Chips können nicht gleichzeitig mit maximaler Geschwindigkeit betrieben werden, weil sonst Leistungs- und Temperaturgrenzen überschritten würden. Dieses Problem wird gelegentlich als Dark Silicon beschrieben. Es ist kein Beweis, dass Transistordichte sinnlos geworden wäre, zeigt aber, dass das Nutzen vieler Bauelemente eine andere Aufgabe ist als ihr bloßes Herstellen.
Rückseitige Stromversorgung und neue Verdrahtungsebenen
Mit steigender Transistordichte wird auch die Versorgung aller Schaltkreise schwieriger. Auf der Vorderseite eines Chips konkurrieren Signalverbindungen und breite Stromversorgungsnetze um Platz. Lange Leitungen erzeugen Widerstand, Spannungsabfälle und zusätzliche Verzögerungen. Ein neuer Ansatz verlegt einen Teil der Stromversorgung auf die Rückseite des Siliciums, sodass die oberen Metalllagen stärker für Signale genutzt werden können.
Für diese Backside Power Delivery müssen extrem dünne Wafer kontrolliert bearbeitet, Verbindungen zum Transistorbereich hergestellt und die mechanische Stabilität gewährleistet werden. Intel kombiniert in seinem als 18A bezeichneten Prozess RibbonFET-Transistoren mit der rückseitigen Stromversorgung PowerVia; andere Hersteller verfolgen verwandte Konzepte.
Das Beispiel zeigt, dass moderne Skalierung längst über die Struktur des eigentlichen MOSFETs hinausgeht. Die elektrischen Leitungen, das Leistungsnetz und das Zusammenspiel von Prozessen und Chipdesign bestimmen zunehmend, ob zusätzliche Transistoren auch sinnvoll miteinander arbeiten können.
Chiplets und 3D-Integration: Fortschritt über den einzelnen Die hinaus
Eine weitere Entwicklung verteilt Funktionen auf mehrere Silicium-Dies, die über ein gemeinsames Gehäuse eng miteinander verbunden werden. Solche Chiplets können unterschiedliche Fertigungsprozesse nutzen: Ein hochintegrierter Logikchip arbeitet neben einem Ein-/Ausgabechip oder einem Speicherstapel, für den eine andere Technologie günstiger ist. Das kann große monolithische Dies vermeiden und die Ausbeute sowie die Wiederverwendung verbessern.
Über Silicium-Interposer, organische Substrate, Brückenstrukturen oder direkte Die-zu-Die-Verbindungen lassen sich diese Elemente dicht koppeln. Vertikales Stapeln verringert zudem die Fläche des gesamten Systems. Gleichzeitig steigen Anforderungen an Wärmeabfuhr, Testbarkeit, Stromversorgung und die Zuverlässigkeit der Verbindungen.
Diese Verfahren erhöhen oft die Transistorzahl eines gesamten Pakets, ohne dass im gleichen Verhältnis die Dichte der Transistoren auf einem einzelnen Silicium-Die zunimmt. Chiplets sind damit eine Fortsetzung der Systemintegration, aber nicht dasselbe wie das ursprüngliche Mooresche Skalierungsgesetz. Gerade diese begriffliche Trennung hilft, Fortschritte der heutigen Halbleitertechnik realistisch einzuordnen.
Ist Moores Gesetz jetzt also tot?
Die Antwort hängt davon ab, was man mit dem Begriff meint. Die Zahl der Transistoren, die sich in fortschrittlichen Chips unterbringen lassen, ist über Jahrzehnte dramatisch gestiegen und wächst durch neue Fertigungs- und Entwurfsmethoden weiter. Dagegen haben sich die früher nahezu parallel verlaufenden Entwicklungen von Transistordichte, Taktfrequenz und Kosten pro Transistor deutlich auseinanderentwickelt.
Ein neuer Fertigungsknoten muss heute nicht für jedes Produkt die wirtschaftlich beste Wahl sein. Fortschritte entstehen zusätzlich durch Architekturen, die vorhandene Transistoren effizienter nutzen, durch spezialisierte Beschleuniger, Chiplets und neue Verbindungstechniken. Die klassische Idee, mit jeder Generation automatisch gleichzeitig schneller, günstiger und sparsamer zu werden, ist zu einfach geworden.
Moores Beobachtung bleibt dennoch eine der einflussreichsten Prognosen der Technikgeschichte. Sie zeigte, dass Fortschritt in integrierten Schaltungen nicht nur von neuen physikalischen Prinzipien, sondern auch von einem sich ständig verändernden wirtschaftlichen Optimum abhängt. Dass die Industrie mehr als sechs Jahrzehnte lang versucht hat, dieses Optimum in immer feinere Strukturen zu verschieben, erklärt einen großen Teil der digitalen Revolution. Moores Gesetz war nie ein Naturgesetz – aber es prägte die Entscheidungen der Menschen, die moderne Chips entwickelten.
Quellen und weiterführende Literatur
- Gordon E. Moore: Cramming More Components onto Integrated Circuits, Electronics (1965)
- Computer History Museum: Moores Gesetz von 1965 und die Änderung von 1975
- R. H. Dennard et al.: Design of Ion-Implanted MOSFETs with Very Small Physical Dimensions (1974)
- Computer History Museum: Das Skalieren von IC-Prozessregeln (1974)
- Intel: Einführung des High-k/Metal-Gate-Transistors (2007)
- University of California, Berkeley: Der FinFET von Chenming Hus Team (1999)
- Intel: Tri-Gate und industrielle Fertigung (2011/2012)
- ASML: Der Einzug von EUV in die Großserienfertigung (2019)
- Samsung: Beginn der 3-nm-GAA-Fertigung (2022)
- TSMC: Geschäftsbericht 2025, Start der N2-Fertigung
- Intel: PowerVia und RibbonFET im Intel-18A-Prozess
- National Academies: Wirtschaftliche Grundlagen von Moores Gesetz