Die Geschichte der Halbleiterspeicher
14.09.2026
Von der Sechs-Transistor-Zelle des SRAM über Dennards Ein-Transistor-DRAM bis zu EPROM, EEPROM, Flash und 3D-NAND.
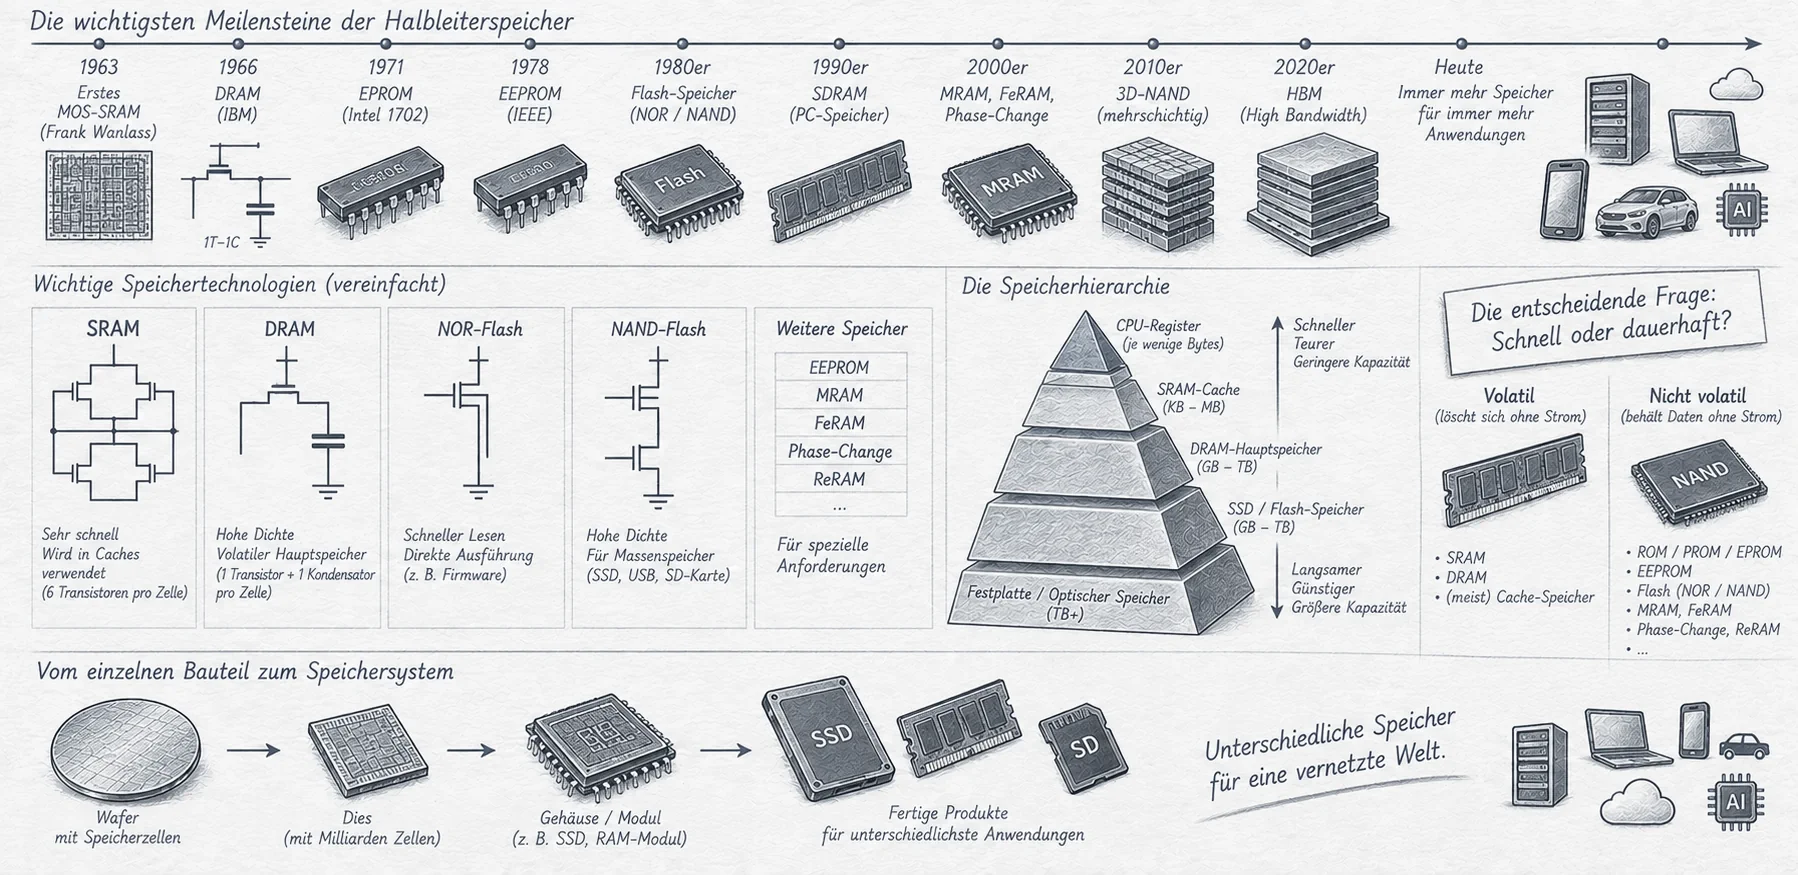
Bild: ChatGPT
Neben dem Prozessor besitzt jeder Rechner eine zweite, ebenso lange Entwicklungsgeschichte: die des Speichers. Ein schneller Rechenkern hilft wenig, wenn er ständig auf Daten warten muss. Die Ingenieure standen daher immer wieder vor derselben Aufgabe: Informationen schneller, dichter, billiger und möglichst dauerhaft zu speichern. Diese Ziele widersprechen einander häufig. Eine Speicherzelle, die sich besonders schnell lesen lässt, benötigt meist mehr Fläche als eine extrem kompakte Zelle; nichtflüchtige Speicher wiederum lassen sich oft langsamer und nur begrenzt häufig neu beschreiben.
Aus diesen Zielkonflikten entstanden verschiedene Halbleitertechnologien: SRAM und DRAM als flüchtige Arbeitsspeicher, EPROM und EEPROM für änderbare Programme und schließlich Flash für die Massenspeicherung. Heute kommen spezialisierte Lösungen wie HBM hinzu, bei denen mehrere Speicherchips dreidimensional miteinander verbunden werden. Die Geschichte dieser Bauelemente zeigt besonders anschaulich, wie Halbleiterphysik, Fertigungstechnik und die Architektur ganzer Computer zusammenhängen.
Vor den Speicherchips: Magnetkerne und Drahtgeflechte
In den 1950er- und 1960er-Jahren bestand der Arbeitsspeicher vieler Computer aus winzigen Ferritringen. Durch jeden Magnetkern liefen Drähte; seine Magnetisierungsrichtung repräsentierte eine Null oder Eins. Diese Speicher waren nichtflüchtig und für ihre Zeit robust. Ihre Herstellung war jedoch teuer, weil große Mengen einzelner Kerne positioniert und verdrahtet werden mussten. Mit wachsendem Speicherbedarf wurden Größe, Energiebedarf und Fertigungsaufwand immer problematischer.
Die frühen integrierten Schaltungen versprachen einen anderen Ansatz: Statt Millionen mechanisch angeordneter Teile sollten die Speicherzellen in einem gemeinsamen Fertigungsprozess auf Silicium entstehen. Die ersten Halbleiterspeicher boten zunächst nur wenige Bit pro Chip und waren nicht automatisch günstiger als Magnetkerne. Sie konnten aber von den Fortschritten der Lithografie und der automatisierten Waferfertigung profitieren. Mit jeder neuen Generation stieg die Speicherdichte, während die Kosten pro Bit langfristig sanken.
1960er-Jahre: SRAM – schnell, aber mit hohem Flächenbedarf
Die ersten integrierten Halbleiterspeicher nutzten vielfach bipolare Transistoren. Bereits 1965 erschienen kommerzielle statische Speicherchips mit kleinen Kapazitäten; auch IBM entwickelte frühe Halbleiter-RAMs für spezielle Computeranwendungen. Mit der MOS-Technik wurden ab der zweiten Hälfte der 1960er-Jahre einfachere und dichtere SRAM-Strukturen möglich. Fairchild lieferte beispielsweise 1968 Baugruppen mit mehreren 64-Bit-MOS-Speicherchips.
Ein typisches modernes SRAM-Bit besteht aus sechs MOS-Transistoren, die zwei miteinander rückgekoppelte Inverter und zwei Zugriffstransistoren bilden. Die Zelle besitzt zwei stabile Zustände, solange sie mit Spannung versorgt wird. Anders als beim DRAM ist kein regelmäßiges Auffrischen erforderlich. Das vereinfacht den schnellen Zugriff, kostet aber Chipfläche: Sechs Transistoren lassen sich nicht so dicht anordnen wie eine Zelle mit nur einem Transistor und einem Kondensator.
Die Rolle von SRAM änderte sich daher mit der Speicherhierarchie. Anfangs konnte es als eigenständiger schneller Arbeitsspeicher dienen; später wurde es besonders als Cache innerhalb von Mikroprozessoren wichtig. Der kurze Abstand zwischen Rechenkern und Cache spart Verzögerungen beim Zugriff. Auch Registerdateien, kleinere Pufferspeicher und zeitkritische Steuerungen greifen auf statische Speicherstrukturen zurück. SRAM wurde nicht durch DRAM ersetzt – beide Technologien fanden unterschiedliche Aufgaben.
1966–1970: Robert Dennard und die Entstehung des DRAM
Der IBM-Forscher Robert Dennard erkannte 1966, dass sich ein gespeichertes Bit deutlich einfacher darstellen lässt: Ein einziger MOS-Transistor regelt den Zugang zu einem kleinen Kondensator. Die Ladung des Kondensators repräsentiert den logischen Zustand. Dennards Patentanmeldung erfolgte 1967; das entsprechende US-Patent wurde 1968 erteilt. Dieses Ein-Transistor-DRAM-Prinzip legte die Grundlage für die später dominierenden hochdichten Arbeitsspeicher.
Die Idee war anspruchsvoll, weil der Kondensator seine Ladung durch Leckströme verliert. Zudem stört der Lesevorgang den gespeicherten Zustand: Die Ladung wird mit der Bitleitung geteilt und muss nach der Erkennung wiederhergestellt werden. DRAM benötigt daher Leseverstärker und eine regelmäßige Auffrischung (Refresh). Eine häufig verwendete Spezifikation verlangt, dass sämtliche Zeilen innerhalb eines vorgegebenen Intervalls, beispielsweise 64 Millisekunden unter bestimmten Bedingungen, aufgefrischt werden. Der konkrete Wert hängt von Baustein und Temperatur ab.
1970: Der Intel 1103 verdrängt den Magnetkernspeicher
Der kommerzielle Durchbruch gelang 1970 mit Intels 1103, einem dynamischen RAM mit 1.024 Bit. Eine historische Besonderheit: Der 1103 basierte noch nicht auf Dennards Ein-Transistor-Zelle, sondern auf einer Drei-Transistor-Architektur, die auf Arbeiten unter anderem von Bill Regitz und Joel Karp zurückging. Erst in späteren Speichergenerationen setzte sich die kompaktere Ein-Transistor-Zelle weitgehend durch.
Auch der 1103 war anfänglich schwierig herzustellen und erforderte sorgfältige elektrische Abstimmung. Dennoch sank der Preis pro Bit so stark, dass Halbleiterspeicher erstmals ernsthaft mit magnetischen Kernen konkurrierten. Die Hersteller steigerten die Kapazität in rascher Folge. In den 1970er-Jahren entstanden Bausteine mit 4, 16 und 64 Kilobit. Entscheidend waren nicht nur kleinere Strukturbreiten: Verbesserte Fertigungsausbeute, gezielte Ionenimplantation, eine platzsparende Adressierung und leistungsfähige Leseverstärker machten daraus wirtschaftlich nutzbare Produkte.
Warum der DRAM-Kondensator immer schwieriger wurde
Mit schrumpfenden Speicherzellen wurde der Kondensator zum technologischen Engpass. Um einen Zustand sicher zu unterscheiden, muss noch ausreichend Ladung gespeichert werden; zugleich sinkt bei kleinerer Fläche die Kapazität. Leckströme, Strahlungseinflüsse und elektrische Störungen können ein Bit verändern. In der Fertigung entstanden deshalb aufwendige Lösungen, bei denen die Speicherfläche dreidimensional genutzt wurde.
Ein Ansatz sind Trench-Kondensatoren, die tief in das Silicium geätzt werden. Ein anderer verwendet gestapelte Kondensatoren, die sich oberhalb der Transistorebene aufbauen lassen. Besonders dünne Dielektrika mit hoher Permittivität erhöhen die Kapazität bei begrenzter Grundfläche. Die Geschichte des DRAM ist darum auch die Geschichte immer komplexerer Ätz-, Abscheide- und Isolationsprozesse.
Während die einzelnen Zellen kleiner wurden, mussten die Speicherchips gleichzeitig immer mehr Daten bei höheren Übertragungsraten bereitstellen. Aus asynchronen DRAMs gingen synchron arbeitende SDRAM-Generationen sowie DDR-Speicher mit Datenübertragung an beiden Taktflanken hervor. Der Speicherchip wurde damit zu einem komplexen System aus Zellfeldern, interner Steuerung und schnellen Schnittstellen.
1971: EPROM – ein Transistor erinnert sich ohne Strom
SRAM und DRAM verlieren ihren Inhalt, sobald die Versorgung ausfällt. Für Firmware und dauerhaft gespeicherte Programme war ein anderer Ansatz nötig. Dawon Kahng und Simon Sze beschrieben 1967 das Potential eines elektrisch isolierten, ladungsspeichernden Floating Gates. Bei Intel nutzte Dov Frohman dieses Prinzip zur Entwicklung des EPROM; 1971 erschien mit dem 1702 ein kommerzieller Baustein mit 2.048 Bit.
Elektronen werden beim Programmieren auf ein von Isolator umgebenes Floating Gate gebracht. Die gespeicherte Ladung verschiebt die Schwellspannung des Transistors und lässt sich später elektrisch auslesen. Weil keine leitende Verbindung zum Gate existiert, bleibt die Information auch ohne Versorgung über lange Zeit erhalten. Zum Löschen musste man jedoch intensive UV-Strahlung verwenden. Klassische EPROMs besaßen dafür ein Quarzfenster im Gehäuse. Das Bauteil musste häufig ausgebaut und anschließend vollständig neu programmiert werden.
Der EPROM machte Softwareänderungen und Firmwareentwicklung flexibler: Ein Programm musste nicht mehr durch eine neue fest verdrahtete Masken-ROM ersetzt werden. In zahlreichen Mikrocomputern, Steuergeräten und Entwicklungsgeräten waren solche Speicher lange Zeit unverzichtbar.
1970er- und 1980er-Jahre: EEPROM – elektrisch und gezielt löschen
Der nächste Schritt war das Electrically Erasable Programmable Read-Only Memory (EEPROM). Eine wesentliche Grundlage entstand in den 1970er-Jahren durch die Arbeiten von Eli Harari an dünnen Tunneloxiden. George Perlegos entwickelte bei Intel eine frühe kommerzielle EEPROM-Architektur; wichtige Arbeiten stammen aus dem Jahr 1978. Durch eine hohe Feldstärke können Elektronen mittels Fowler-Nordheim-Tunneln eine extrem dünne Isolationsschicht überwinden. Daten ließen sich nun ohne UV-Lampe und ohne Ausbau elektrisch ändern.
Klassische EEPROMs unterstützen häufig das Löschen und Beschreiben einzelner Bytes oder kleiner Bereiche. Sie benötigen dafür zusätzliche Zell- und Auswahlschaltungen und sind pro Bit teurer als DRAM oder NAND-Flash. Das ist bei wenigen hundert oder tausend Speicherstellen jedoch akzeptabel: Konfigurationsparameter, Kalibrierdaten oder Gerätekennungen müssen nur selten geändert werden und sollen auch nach einem Stromausfall erhalten bleiben.
1980er-Jahre: Flash – ein neuer Kompromiss verändert den Markt
Fujio Masuoka und sein Team bei Toshiba entwickelten Anfang der 1980er-Jahre die Grundlagen des Flash-Speichers. Die Idee war, auf die feingranulare Löschung klassischer EEPROMs zu verzichten und Speicherbereiche gemeinsam zu löschen. Dadurch wurden höhere Bitdichten und niedrigere Kosten möglich. Konzepte für NOR-Flash wurden 1984 vorgestellt; NAND-Flash folgte 1987. Die Industrialisierung unterschiedlicher Flash-Bauformen erfolgte schrittweise und mit Beiträgen mehrerer Hersteller.
Bei NOR-Flash können einzelne Speicherworte relativ direkt adressiert werden. Das eignet sich besonders für Firmware und Code, der teilweise direkt aus dem Speicher ausgeführt wird. NAND-Flash verschaltet mehrere Speicherzellen in Seriensträngen und erzielt eine höhere Dichte. Für beliebige kleine Schreibzugriffe ist diese Bauart weniger bequem; bei der Speicherung großer Datenmengen ist sie dagegen besonders wirtschaftlich.
Flash-Speicher behält die Daten ohne Strom, ist aber kein unbegrenzt oft beschreibbarer Speicher. Wiederholte Programmier- und Löschvorgänge beanspruchen die dünnen Isolationsschichten. Hinzu kommen Fehler durch verlorene Ladung und gegenseitige Beeinflussung benachbarter Zellen. Für USB-Sticks, Speicherkarten und SSDs wurden deshalb Fehlerkorrektur, Ersatzblöcke und eine intelligente Verteilung der Schreibvorgänge zunehmend unverzichtbar.
Mehr Bits pro Zelle – und weniger Abstand zwischen den Zuständen
Anfangs speicherte eine Flash-Zelle nur ein Bit mit zwei unterscheidbaren Zuständen (SLC). Später ermöglichten fein abgestufte Schwellspannungen zwei, drei oder vier Bits pro Zelle, bezeichnet als MLC, TLC und QLC. Dadurch steigt die Kapazität, ohne dass die Anzahl physischer Zellen entsprechend wachsen muss.
Die zusätzlichen Zustände liegen jedoch dichter beieinander. Elektrisches Rauschen, Alterung und Ladungsverluste lassen sich schwerer von den beabsichtigten Pegeln unterscheiden. Der Speichercontroller benötigt präzisere Programmierverfahren und aufwendigere Fehlerkorrektur. Die maximale Zahl der Programmier- und Löschzyklen ist bei hochverdichteten Zellkonzepten oft geringer. Die günstigste Lösung pro gespeichertem Bit ist daher nicht zwangsläufig die robusteste für jeden Einsatz.
Vom Flash-Baustein zur SSD: Ein Controller wird unverzichtbar
Ein NAND-Flash-Chip verhält sich nicht wie ein einfacher Arbeitsspeicher. Daten werden in Seiten geschrieben, größere Blöcke werden gemeinsam gelöscht. Bereits belegte Speicherstellen lassen sich nicht beliebig überschreiben. Daher benötigt ein Laufwerk einen Controller, der logische Adressen auf physische Speicherstellen abbildet (Flash Translation Layer), die Abnutzung verteilt (Wear Leveling) und nicht mehr brauchbare Blöcke aussondert.
Mit leistungsfähiger Fehlerkorrektur, Zwischenspeichern und parallelem Zugriff auf mehrere NAND-Kanäle entwickelten sich Flash-Produkte vom Wechselspeicher zum schnellen Massenspeicher. SSDs verzichteten auf die Mechanik von Festplatten, boten kurze Zugriffszeiten und reduzierten die Zahl beweglicher Teile. Die tatsächliche Lebensdauer hängt allerdings von Schreiblast, Zelltyp, Temperatur und Controllerstrategie ab.
2007–2013: Der Weg vom planaren zum dreidimensionalen NAND
Als planare Flash-Zellen immer kleiner wurden, erschwerten Nachbarzellkopplung und geringere gespeicherte Ladungsmengen die weitere Skalierung. Einen Ausweg bot die dritte Dimension. Toshiba stellte 2007 mit BiCS ein Konzept für vertikal organisierte NAND-Zellstrukturen vor. Im August 2013 begann Samsung die Serienfertigung seines 3D-V-NAND mit zunächst 24 vertikalen Zellebenen. Die Fertigung wurde damit nicht einfach um übereinandergestapelte fertige Chips ergänzt: Viele Speicherzellen entstanden direkt als dreidimensionaler Aufbau innerhalb eines einzelnen Dies.
Dazu scheidet die Fertigung eine Vielzahl dünner Materialschichten ab. Anschließend werden sehr tiefe, schmale Öffnungen geätzt, durch die vertikale Kanäle verlaufen. Viele 3D-NAND-Generationen verwenden eine Charge-Trap-Struktur, bei der Ladung in isolierenden Schichten statt auf einem durchgehenden leitenden Floating Gate gespeichert wird. Der Prozess ist aufwendig, erlaubt aber die Erhöhung der Kapazität durch zusätzliche Schichten, ohne jeden einzelnen Zellabstand ständig weiter zu verkleinern.
Mit späteren Generationen wuchs die Zahl der Ebenen von einigen Dutzend auf mehrere Hundert. Dafür müssen die Hersteller enorme Anforderungen an Gleichmäßigkeit, Hochaspekt-Ätzprozesse und elektrische Kontaktierung bewältigen. Der Fortschritt kam also nicht durch das bloße Stapeln, sondern durch neue Fertigungsmethoden für extrem tiefe Strukturen.
DRAM wird schneller: SDRAM, DDR und Spezialspeicher
Auch beim flüchtigen Arbeitsspeicher setzte sich die Entwicklung fort. SDRAM koppelte den Betrieb an einen Systemtakt, sodass Datenübertragungen planbar in aufeinanderfolgenden Schritten erfolgen konnten. DDR-Speicher erhöhten den Datendurchsatz durch Übertragungen an steigender und fallender Taktflanke; spätere Generationen verbesserten Signaltechnik, Bankorganisation und Energiemanagement. In mobilen Geräten setzte sich außerdem auf geringe Leistungsaufnahme optimiertes LPDDR durch.
Für Grafikkarten entstanden spezialisierte GDDR-Speicher mit besonders hohen Datenraten. Diese Lösungen zeigten ein neues Problem: Zwar wurden Transistoren schneller und die Speicherkapazität größer, aber die Übertragung von immer mehr Daten über Leiterplattenverbindungen wurde energetisch und elektrisch teuer. Rechenleistung allein genügte nicht mehr; die Speicherbandbreite wurde zu einer eigenständigen Leistungsgrenze.
HBM: Speicherchips werden dreidimensional verbunden
High Bandwidth Memory (HBM) verfolgt einen anderen Weg als 3D-NAND. Hier entstehen die Speicherzellen weiterhin auf einzelnen DRAM-Dies, die anschließend übereinandergestapelt und beispielsweise über Through-Silicon Vias (TSVs) miteinander verbunden werden. Eine sehr breite Schnittstelle und kurze Leitungswege erlauben einen hohen Datendurchsatz bei vergleichsweise niedriger Signalenergie. HBM liegt häufig gemeinsam mit Prozessoren oder KI-Beschleunigern auf einem fortschrittlichen Package beziehungsweise Interposer.
SK hynix und AMD entwickelten die frühe HBM-Technik gemeinsam; 2013 meldete SK hynix einen ersten TSV-basierten HBM-Prototyp. 2015 wurde HBM unter anderem in AMDs Radeon R9 Fury X kommerziell eingesetzt. Mit immer leistungsfähigeren GPUs und KI-Beschleunigern wurde die Fähigkeit, große Datenmengen schnell bereitzustellen, schließlich zu einem zentralen Merkmal moderner Rechensysteme.
Obwohl sowohl HBM als auch 3D-NAND mit vertikalen Strukturen arbeiten, sind ihre Herstellungsprinzipien verschieden: 3D-NAND enthält viele vertikal gefertigte Speicherzellebenen innerhalb eines Dies; HBM verbindet mehrere separat gefertigte DRAM-Dies zu einem Stapel. Das gleiche Wort „3D“ steht hier also für zwei unterschiedliche technologische Entwicklungen.
Speicherhierarchie: Warum die alten Technologien weiterleben
In heutigen Rechnern arbeiten verschiedene Speicherarten gleichzeitig. Kleine SRAM-Caches halten die unmittelbar benötigten Daten nahe am Rechenkern. DRAM liefert größere Kapazitäten als Arbeitsspeicher. NAND-Flash speichert Programme und Nutzdaten dauerhaft. Spezialisierte HBM-Pakete versorgen leistungsfähige Prozessoren mit hoher Bandbreite, während kleine nichtflüchtige Bausteine weiterhin Einstellungen und Startinformationen sichern.
Keine dieser Entwicklungen hat die anderen vollständig ersetzt. Ihre jeweiligen Stärken beruhen auf unterschiedlichen physikalischen Prinzipien und unterschiedlichen Kosten pro Bit, Zugriffszeiten und Zuverlässigkeitsanforderungen. Der große Fortschritt der Halbleiterspeicher bestand deshalb nicht in der Erfindung einer perfekten Speicherzelle. Er bestand darin, immer passendere Speichertechniken zu entwickeln – und sie so zu kombinieren, dass ein ganzes Computersystem leistungsfähiger wird.
Quellen und weiterführende Literatur
- Computer History Museum: Semiconductor Memories Compete with Magnetic Cores (1970)
- Computer History Museum: MOS Dynamic RAM and the Intel 1103 (1970)
- IBM: The History of Dynamic Random-Access Memory
- Computer History Museum: Reusable Semiconductor ROM Introduced (1971)
- IEEE Engineering and Technology History Wiki: The Floating Gate EEPROM, 1976–1978
- Kioxia: The Development of BiCS FLASH (3D NAND)
- Samsung: First Mass Production of 3D Vertical NAND Flash (2013)
- SK hynix: The Story of HBM Development