Die Geschichte des FET
14.09.2026
34 Jahre zwischen Patent und erstem funktionierendem Bauelement – und danach drei völlig unterschiedliche physikalische Bauformen desselben Grundprinzips.
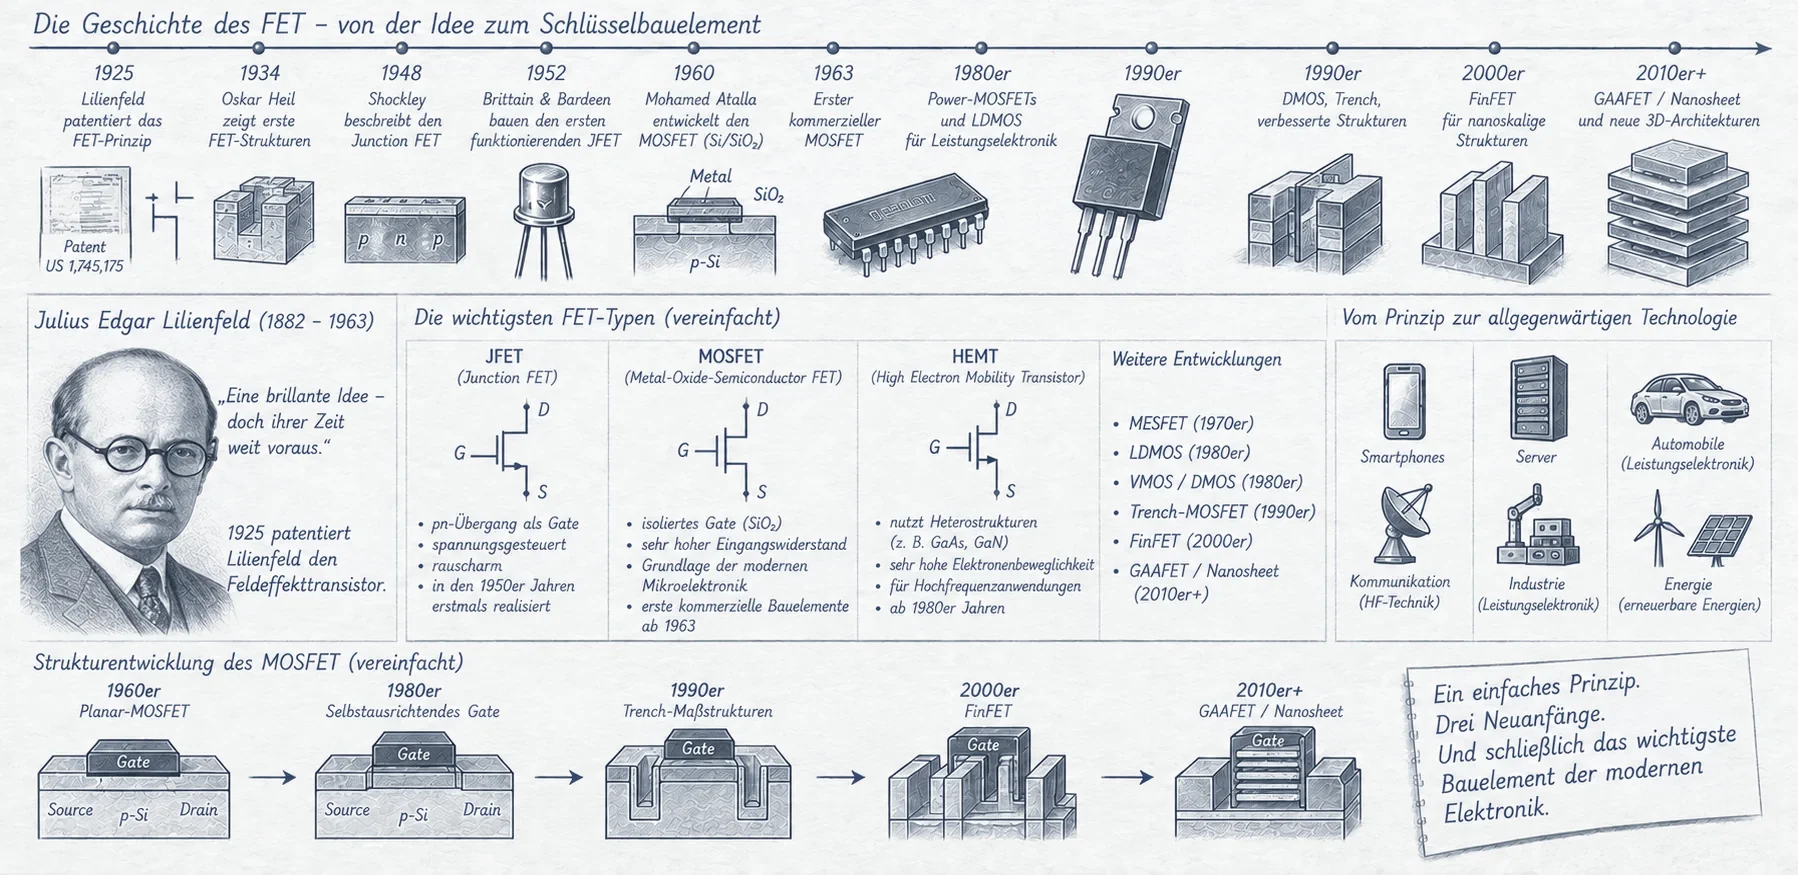
Bild: ChatGPT
Im Dezember 1947 demonstrierten John Bardeen und Walter Brattain bei den Bell Laboratories den ersten funktionierenden Transistor. Das Experiment gilt zu Recht als Meilenstein der Elektronik. Die ursprüngliche Idee eines Transistors war jedoch wesentlich älter: Bereits in den 1920er-Jahren wollte Julius Edgar Lilienfeld den Strom in einem Halbleiter mit einem elektrischen Feld steuern. Genau dieses Prinzip prägt die heutige Mikroelektronik – und trotzdem dauerte es Jahrzehnte, bis geeignete Materialien und Fertigungsverfahren zur Verfügung standen.
Der Weg führte über verworfene Patente, die schwierige Physik von Halbleiteroberflächen, den Sperrschicht-FET und schließlich zum MOSFET. Später wurde aus einzelnen n- und p-Kanal-Transistoren die stromsparende CMOS-Logik; der zunächst flache Kanal verwandelte sich erst in eine Siliciumfinne und dann in übereinandergestapelte Nanoschichten. Die Geschichte des Feldeffekttransistors (FET) ist deshalb nicht nur die Geschichte eines Bauelements, sondern auch die Geschichte der Methoden, mit denen Ingenieure ein elektrisches Feld immer präziser kontrollieren lernten.
Was einen FET überhaupt ausmacht
Ein Bipolartransistor verstärkt, indem Ladungsträger über einen pn-Übergang in die dünne Basis injiziert werden. Beim Feldeffekttransistor wird der Leitwert eines Kanals dagegen durch ein elektrisches Feld verändert. Die drei wichtigsten Anschlüsse heißen Source, Drain und Gate. Über Source und Drain fließt der zu steuernde Strom; die Gate-Spannung beeinflusst, ob und wie gut der Kanal leitet.
Beim später dominierenden MOSFET trennt eine dünne Isolatorschicht das Gate vom Halbleiter. Im idealen Gleichstrombetrieb muss deshalb kaum Strom in das Gate fließen. Das ist ein großer Unterschied zur Ansteuerung vieler bipolarer Schaltungen. In realen modernen Transistoren treten allerdings Leckströme auf, und bei jedem Umschalten muss die Gate-Kapazität elektrisch geladen oder entladen werden. Auch CMOS verbraucht deshalb bei hohen Schaltfrequenzen beträchtliche Leistung.
Feldeffekttransistoren sind zudem keine einzelne Bauform. Beim JFET (Junction Field-Effect Transistor) verändert ein in Sperrrichtung betriebener pn-Übergang die Breite des leitenden Kanals. Beim MOSFET steuert ein isoliertes Gate die Oberflächenleitfähigkeit. In FinFETs und Gate-All-Around-FETs bleibt das Grundprinzip erhalten, aber die räumliche Anordnung von Gate und Kanal verändert sich. Diese Unterschiede sind entscheidend für die historische Entwicklung.
Zwei Patente, kein industrietaugliches Bauelement
Der Erfinder Julius Edgar Lilienfeld meldete 1926 in den Vereinigten Staaten ein Patent für eine Vorrichtung an, deren Stromfluss durch eine dritte Elektrode gesteuert werden sollte. Weitere Anmeldungen folgten. Der Gedanke ähnelte bereits stark dem späteren Feldeffekttransistor: Ein äußeres elektrisches Feld sollte den Halbleiter beeinflussen, ohne selbst den zu steuernden Strompfad zu bilden. Noch gab es jedoch keinen überzeugend dokumentierten, reproduzierbar arbeitenden Transistor nach diesem Konzept.
1934 beschäftigte sich der deutsche Ingenieur und Physiker Oskar Heil unabhängig mit einer verwandten Idee. Auch er versuchte, einen Strom durch kapazitive Kopplung von einer Steuerelektrode aus zu verändern. Beide Patentrichtungen waren erstaunlich vorausschauend. Die damalige Technik konnte ihre Versprechen aber kaum einlösen: Reine, einkristalline Halbleiter standen nur eingeschränkt zur Verfügung, Dotierungen waren schwer zu kontrollieren und das Verhalten von Grenzflächen blieb unzureichend verstanden.
Die frühen Patente zeigen zugleich, warum es schwierig ist, eine technische Erfindung auf ein einzelnes Datum zu reduzieren. Eine theoretisch sinnvolle Struktur, ein angemeldetes Patent, ein nachweislich funktionierender Laboraufbau und ein verlässlich in Serie gefertigtes Produkt sind vier unterschiedliche Entwicklungsstufen. Beim FET lagen zwischen ihnen mehrere Jahrzehnte.
1945: Shockleys eigener Fehlversuch
Nach dem Zweiten Weltkrieg suchten die Bell Laboratories einen Ersatz für Elektronenröhren in Verstärkern und Schaltern. William Shockley wollte zunächst ebenfalls ein elektrisches Feld zur Steuerung eines Halbleiterkanals nutzen. Seine Versuche von 1945 und anschließende Experimente lieferten jedoch nicht den erwarteten Effekt.
Der junge Physiker John Bardeen erarbeitete eine wesentliche Erklärung. An der Oberfläche eines Halbleiters können elektronische Zustände Ladungen aufnehmen. Solche Oberflächenzustände verändern die elektrische Feldverteilung und können eine an der Oberfläche angelegte Spannung wirksam abschirmen. Ein Gate beeinflusst dann nicht den Halbleiter in der vorgesehenen Weise. Das Problem war nicht einfach eine unzureichend hohe Betriebsspannung; die Eigenschaften der Grenzfläche selbst mussten beherrscht werden.
Die Untersuchung dieser Effekte führte Bardeen und Walter Brattain auf einen anderen Weg. Im Dezember 1947 demonstrierten sie einen Verstärker mit zwei eng benachbarten Metallkontakten auf einem Germaniumkristall. Damit war der erste funktionsfähige Punktkontakttransistor entstanden – allerdings ein Bauelement mit einer anderen Arbeitsweise als der ursprünglich angestrebte isoliert angesteuerte FET. Der frühe Erfolg bipolarer Transistoren ließ den Feldeffekt zunächst in den Hintergrund treten.
1953: Der Sperrschicht-FET wird Wirklichkeit
Die Feldeffektidee verschwand dennoch nicht. Bei Bell Labs entwickelten George Dacey und Ian Ross einen praktisch funktionierenden Sperrschicht-FET (JFET); ihre Ergebnisse wurden 1953 veröffentlicht. Anders als beim späteren MOSFET liegt die Gate-Elektrode nicht isoliert über dem Kanal. Stattdessen bildet sie einen pn-Übergang zum Halbleiter. Wird dieser in Sperrrichtung betrieben, verbreitert sich die Raumladungszone und engt den Strompfad ein.
Ein n-Kanal-JFET kann beispielsweise bei einer geeigneten Gate-Spannung gut leiten. Durch eine zunehmend negative Gate-Spannung gegenüber der Source wächst die Raumladungszone, bis der Kanal nahezu abgeschnürt wird. Dabei fließt nur ein kleiner Sperrstrom am Gate. Das Verfahren machte eine zuverlässige feldgesteuerte Verstärkung möglich, ohne bereits eine perfekte oxidisolierte Gate-Struktur vorauszusetzen.
JFETs fanden unter anderem in hochohmigen Eingangsverstärkern, empfindlicher Messtechnik und rauscharmen Schaltungen Verwendung. Sie wurden aber nicht zur dominierenden Grundlage der digitalen Mikroelektronik. Ihr Gate benötigt einen pn-Übergang mit eigener Geometrie und ihr Aufbau lässt sich weniger einfach zu extrem dichten, komplementären Schaltern kombinieren. Der industrielle Durchbruch der Feldeffekttechnik sollte deshalb auf einem anderen Weg erfolgen.
1955–1960: Die Siliciumoberfläche wird beherrschbar
Den fehlenden technologischen Schlüssel lieferte das Siliciumdioxid (SiO2). Bereits 1955 untersuchten Carl Frosch und Lincoln Derick bei Bell Labs Oxidschichten auf Silicium. Sie zeigten, dass solche Schichten die Oberfläche schützen und bei der kontrollierten Dotierung als Maske dienen können. Damit wurde Silicium mehr als nur ein weiterer Halbleiterwerkstoff: Sein Oxid erwies sich als außerordentlich nützliches Prozessmaterial.
Mohamed M. Atalla erforschte anschließend, wie thermisch gewachsenes Oxid die störenden Oberflächenzustände und die elektrischen Eigenschaften der Grenzfläche verbessern konnte. Oberflächenpassivierung bedeutete nicht, sämtliche Defekte vollständig zu beseitigen. Aber sie reduzierte unerwünschte Einflüsse so weit, dass eine reproduzierbare Steuerung des darunterliegenden Siliciums möglich wurde.
Gemeinsam mit Dawon Kahng fertigte Atalla 1959 einen erfolgreichen MOS-Feldeffekttransistor, der 1960 öffentlich vorgestellt wurde. Zwischen Metall-Gate und Siliciumkanal lag ein dünnes Oxid als Isolator – daraus entstand der Name Metal-Oxide-Semiconductor FET. Das elektrische Feld konnte nun die Ladungsträgerkonzentration an der Grenzfläche verändern und unter geeigneten Bedingungen einen leitenden Kanal erzeugen.
Die ersten MOSFETs waren noch langsam und technologisch anspruchsvoll. Die Ingenieure mussten Gateoxid, Oberflächenreinheit, Schwellenwerte und Kontakte kontrollieren. Rückblickend war aber gerade die unscheinbare Grenzfläche zwischen Oxid und Silicium der entscheidende Durchbruch: Sie öffnete den Weg zu einem Transistor, dessen Struktur sich in großer Zahl mit wiederholbaren Fertigungsschritten herstellen ließ.
PMOS, NMOS und der Weg zum Massenprodukt
Frühe MOS-Schaltungen waren vielfach p-Kanal-Schaltungen (PMOS). Der Grund war nicht, dass Löcher grundsätzlich die schnelleren Ladungsträger wären – in Silicium sind Elektronen beweglicher. Vielmehr beeinflussten positive Oxidladungen und bewegliche Verunreinigungen, vor allem Natriumionen, die Schwellenspannungen von n-Kanal-MOSFETs ungünstig. Die Fertigung musste erst sauberer und die Oxide stabiler werden.
1964 boten Unternehmen wie General Microelectronics kommerzielle MOS-Schaltungen an. In Taschenrechnern, Steuerungen und Speicherbausteinen wurden hohe Integrationsdichte und eine überschaubare Zahl von Prozessschritten besonders attraktiv. Der 1971 vorgestellte Intel 4004 verwendete noch PMOS-Technologie. Damit gelang eine große Systemfunktion auf einem Chip, obwohl die Schaltungen im Vergleich zu späteren n-Kanal-Technologien relativ langsam waren.
Als Reinheit, Oxidprozesse und Schwellenspannungskontrolle besser wurden, setzten sich NMOS-Schaltungen für viele Anwendungen durch. Der höhere Elektronentransport ermöglichte schnellere Logik. Prozessoren und Speicher der 1970er-Jahre profitierten davon; Beispiele sind Intels 8080 und weitere NMOS-Generationen. Allerdings zog eine Logikfamilie, die aus nur einer dominierenden Transistorpolarität bestand, typischerweise auch im Ruhezustand Strom. Mit immer mehr Transistoren auf einem Chip wurde die Verlustleistung daher zum zentralen Engpass.
1963: Ein FET wird zwei – die CMOS-Idee
Den Weg aus diesem Problem hatte Frank Wanlass bei Fairchild bereits 1963 beschrieben. Gemeinsam mit Chih-Tang Sah veröffentlichte er eine komplementäre MOS-Schaltung, in der ein n-Kanal- und ein p-Kanal-Transistor zusammenarbeiten. Das Konzept wurde später als CMOS (Complementary Metal-Oxide-Semiconductor) bekannt.
In einem CMOS-Inverter verbindet der p-Kanal-Transistor den Ausgang bei niedrigem Eingangssignal mit der positiven Versorgung; der n-Kanal-Transistor zieht ihn bei hohem Eingangssignal zur Masse. Im idealen stabilen Zustand leitet im Wesentlichen nur einer der beiden Transistoren. Dadurch entsteht kein dauerhafter direkter Strompfad von der Versorgung nach Masse. Strom wird vor allem bei Signalwechseln zum Laden und Entladen von Kapazitäten benötigt; reale Leckströme bleiben zusätzlich bestehen.
Diese Schaltung war zunächst keine offensichtliche wirtschaftliche Lösung. Zwei Transistortypen auf demselben Chip herzustellen erhöhte den Fertigungsaufwand. Zudem galt CMOS lange als langsamer als andere Logikfamilien. Doch die Grundidee verband eine wichtige Eigenschaft mit der fortschreitenden Integration: Die Zahl der Transistoren konnte steigen, ohne dass der statische Stromverbrauch im gleichen Maß wachsen musste.
Warum CMOS nicht sofort gewann
RCA investierte früh in die komplementäre MOS-Technik und stellte 1968 die ersten Schaltkreise der später bekannten CD4000-Familie vor. Solche Bausteine eigneten sich für Anwendungen mit begrenzter Energieversorgung, etwa Raumfahrttechnik und tragbare Geräte. In den 1970er-Jahren gewannen CMOS-Schaltungen insbesondere in batteriebetriebenen Uhren und elektronischen Geräten an Bedeutung.
Für Hochleistungslogik blieb die Konkurrenz zunächst stark. TTL bot bewährte Bausteinfamilien und gut bekannte Schaltungspegel; NMOS war für große integrierte Digitalschaltungen häufig schneller und einfacher. Mit kleineren Strukturbreiten, verbesserten Silicium-Gates und neuen CMOS-Prozessen verringerte sich dieser Nachteil. Spätestens in den 1980er-Jahren wurde CMOS für immer mehr Prozessor- und Speichergenerationen wirtschaftlich attraktiv.
Die entscheidende Grenze war zunehmend nicht mehr die reine Transistorzahl, sondern die beherrschbare Verlustleistung. Je mehr Logik auf einen Chip passte, desto wichtiger wurden niedrige Ruheströme, ausreichende Störabstände und ein gutes Verhältnis von Energieverbrauch und Schaltgeschwindigkeit. CMOS gewann nicht durch einen einzigen überraschenden Versuch, sondern durch die langfristige Anpassung der Fertigung an ein bereits 1963 erkanntes Prinzip.
Wie die Lithografie die Kanallänge verkürzte
Als MOSFETs kleiner wurden, sank die Kanallänge zwischen Source und Drain. Ein kürzerer Kanal erlaubte grundsätzlich schnellere Schaltvorgänge und eine höhere Packungsdichte. In der Praxis mussten dazu Lithografie, Dotierprofile und Oxiddicken immer präziser aufeinander abgestimmt werden. Silicium-Gates, Self-Aligned-Gate-Prozesse und später verbesserte dielektrische Materialien erleichterten diesen Fortschritt.
Mit sehr kurzen Kanälen wuchs jedoch ein neues Problem: Das Gate sollte den leitenden Kanal steuern, aber Source und Drain beeinflussten ihn zunehmend ebenfalls. Es entstanden Kurzkanaleffekte, etwa eine Veränderung der Schwellenspannung und höhere Leckströme. Gleichzeitig durfte das Gateoxid nicht unbegrenzt dünner werden, weil Elektronen sonst verstärkt durch die isolierende Barriere tunneln konnten.
Eine wichtige Antwort war die Einführung von High-k-Dielektrika und Metall-Gates. Ein Material mit höherer Dielektrizitätskonstante kann bei größerer physischer Dicke eine hohe Gate-Kapazität bereitstellen und damit Tunnelleckströme reduzieren. Solche Fortschritte verlängerten die Nutzungsdauer planarer Transistorstrukturen, änderten aber nichts an der wachsenden Schwierigkeit, einen extrem kurzen Kanal nur von oben zu kontrollieren.
Der FET verändert seine Form: FinFETs
Die entscheidende geometrische Änderung war, den Kanal nicht mehr ausschließlich flach an der Waferoberfläche auszubilden. Bei einem FinFET ragt ein schmaler Siliciumsteg – die Finne – aus dem Substrat. Das Gate greift von mehreren Seiten an. Weil es den Kanal dadurch stärker umfasst, kann es die Ladungsträger besser kontrollieren, auch wenn die Transistorabmessungen schrumpfen.
Eine wichtige Forschungsrichtung entstand Ende der 1990er-Jahre an der University of California, Berkeley, unter anderem mit Chenming Hu, Tsu-Jae King Liu und Jeff Bokor. Die Konzepte bauten auf früheren Mehrgate-Transistorideen auf und zeigten, wie sich die elektrostatische Kontrolle bei sehr kurzen Kanälen verbessern ließ. Der Weg vom Forschungsbauelement zum reproduzierbaren Milliardenfach-Bauteil war jedoch lang.
2011 kündigte Intel die Umstellung auf dreidimensionale Tri-Gate-Transistoren im 22-nm-Prozess an. Die entsprechenden Ivy-Bridge-Produkte erreichten 2012 den Markt. Andere Hersteller übernahmen in den folgenden Jahren verwandte FinFET-Architekturen für fortschrittliche Logikprozesse. Die Bezeichnung „22 nm“ ist dabei der Name einer Technologiegeneration und keine einheitliche Messung jeder Transistordimension.
FinFETs führten das Feldeffektprinzip nicht auf eine neue physikalische Grundlage zurück. Sie veränderten vor allem die Kontaktfläche zwischen Gatefeld und Kanal. Genau diese bessere geometrische Kontrolle ermöglichte weitere Transistorgenerationen, ohne die unerwünschten Leckströme in gleichem Maße wachsen zu lassen.
2022: Gate-All-Around und gestapelte Nanoschichten
Auch FinFETs sind nicht beliebig verkleinerbar. Bei sehr schmalen Finnen und immer schwierigeren geometrischen Randbedingungen entstand die Idee, den Kanal vollständig vom Gate umgeben zu lassen. Bei Gate-All-Around-FETs (GAA) liegt das Gate nicht nur an drei Seiten, sondern umschließt den leitfähigen Kanal rundherum.
Eine industrielle Variante nutzt mehrere horizontale Silicium-Nanoschichten, die übereinandergestapelt werden. Durch ihre Breite und die Zahl der Schichten lässt sich die effektive Kanalbreite anpassen. Dadurch entsteht ein zusätzlicher Entwurfsspielraum zwischen Stromtragfähigkeit und Platzbedarf. Die Herstellung verlangt allerdings neue Prozesse, darunter das selektive Entfernen von Zwischenschichten, ohne die verbleibenden Kanäle zu beschädigen.
Samsung kündigte im Juni 2022 den Beginn der Fertigung eines 3-nm-Prozesses mit Nanosheet-GAA-Transistoren an. Andere Hersteller entwickelten eigene Konzepte. Auch hier gilt: Der Name „3 nm“ bezeichnet einen Technologie-Knoten; die tatsächlichen physikalischen Abmessungen hängen von der jeweiligen Struktur ab. Was sich von Lilienfelds Patent bis zu den Nanosheets erhalten hat, ist die Steuerung eines Leitkanals durch ein elektrisches Feld.
Mehr als digitale Logik: Die anderen FET-Familien
Die Dominanz von CMOS in Prozessoren erklärt nicht alle Einsatzgebiete des Feldeffekttransistors. JFETs werden noch heute verwendet, wenn sehr kleine Eingangsströme und günstiges Rauschverhalten gefragt sind. Leistungs-MOSFETs schalten hohe Ströme in Netzteilen, Motorsteuerungen und Gleichspannungswandlern. Ihre Zellen sind anders angeordnet als die Logiktransistoren eines Prozessors, oft mit vertikalem Stromfluss durch den Halbleiter.
Auch bei Hochfrequenz und Hochleistung haben andere Werkstoffe Bedeutung gewonnen. Auf Galliumarsenid- oder Galliumnitridbasis lassen sich etwa MESFETs und HEMTs herstellen, bei denen spezielle Grenzflächen oder Schottky-Kontakte den Kanal beeinflussen. SiC-MOSFETs ermöglichen wiederum verlustarme Leistungselektronik bei hohen Spannungen. Die Geschichte des FET ist daher breiter als die Geschichte des Silicium-MOSFETs.
Diese unterschiedlichen Bauelemente zeigen, dass eine gemeinsame physikalische Grundidee sehr verschiedene industrielle Produkte hervorbringen kann. Das gilt für einen empfindlichen Messverstärker ebenso wie für den Schalter eines Elektromobils oder die Milliarden Logiktransistoren eines modernen Rechenchips.
Ein Jahrhundert Feldeffekt
Die Geschichte des Feldeffekttransistors ist voller scheinbarer Widersprüche. Die Idee existierte vor dem ersten funktionierenden Transistor, doch die ersten großen Erfolge feierte die bipolare Technik. Der JFET bewies bereits 1953, dass eine feldgesteuerte Verstärkung möglich war, während der MOSFET erst mit einer geeigneten Oxidgrenzfläche ab 1959 wirklich funktionierte. CMOS wurde schon 1963 beschrieben, setzte sich aber erst nach langen Verbesserungen der Fertigung breit durch.
Schließlich veränderte sich auch die Geometrie: vom planaren Kanal zu Finnen und vollständig vom Gate umschlossenen Nanoschichten. Immer wieder ging es um dieselbe Aufgabe – das elektrische Feld muss den Strom präzise steuern, während Materialdefekte, parasitäre Effekte und Energieverluste begrenzt bleiben.
Der Fortschritt des FET lässt sich deshalb nicht einer einzigen Person oder einem einzigen Patent zuschreiben. Lilienfeld und Heil formulierten die Idee, Forscher bei Bell Labs entschlüsselten ihre Schwierigkeiten, Dacey und Ross verwirklichten einen frühen JFET, Atalla und Kahng schufen den MOSFET, und Wanlass und Sah erkannten das Potenzial komplementärer Logik. Viele spätere Entwicklungsteams machten daraus zuverlässige und massenhaft gefertigte Transistorstrukturen. Sie bilden heute das Fundament der digitalen Mikroelektronik – und zugleich einen wichtigen Teil moderner Analog-, Hochfrequenz- und Leistungselektronik.
Quellen und weiterführende Literatur
- Computer History Museum: Field Effect Semiconductor Device Concepts Patented (1926)
- Computer History Museum: Invention of the Point-Contact Transistor (1947)
- Computer History Museum: Development of Oxide Masking (1955)
- Computer History Museum: MOS Transistor Demonstrated (1960)
- Computer History Museum: Complementary MOS Configuration (1963)
- University of California, Berkeley: Intel Tri-Gate Based on Berkeley FinFET Research (2011)
- Intel: Intel Reinvents Transistors Using New 3-D Structure (2011)
- Samsung: Production of 3-nm Gate-All-Around Transistors (2022)