Pannen der Halbleitergeschichte: Wenn winzige Fehler große Folgen haben
13.10.2026
Fünf fehlerhafte Tabelleneinträge im Pentium, mikroskopische Zinnfäden zwischen Anschlüssen, ein ungewollt gezündeter Thyristor im CMOS-Chip und einzelne Strahlungsteilchen, die Speicherbits kippen: Die Geschichte der Halbleiter ist auch eine Geschichte überraschender Fehler. Was diese Pannen auslöste – und wie sie die Zuverlässigkeit moderner Elektronik veränderten.
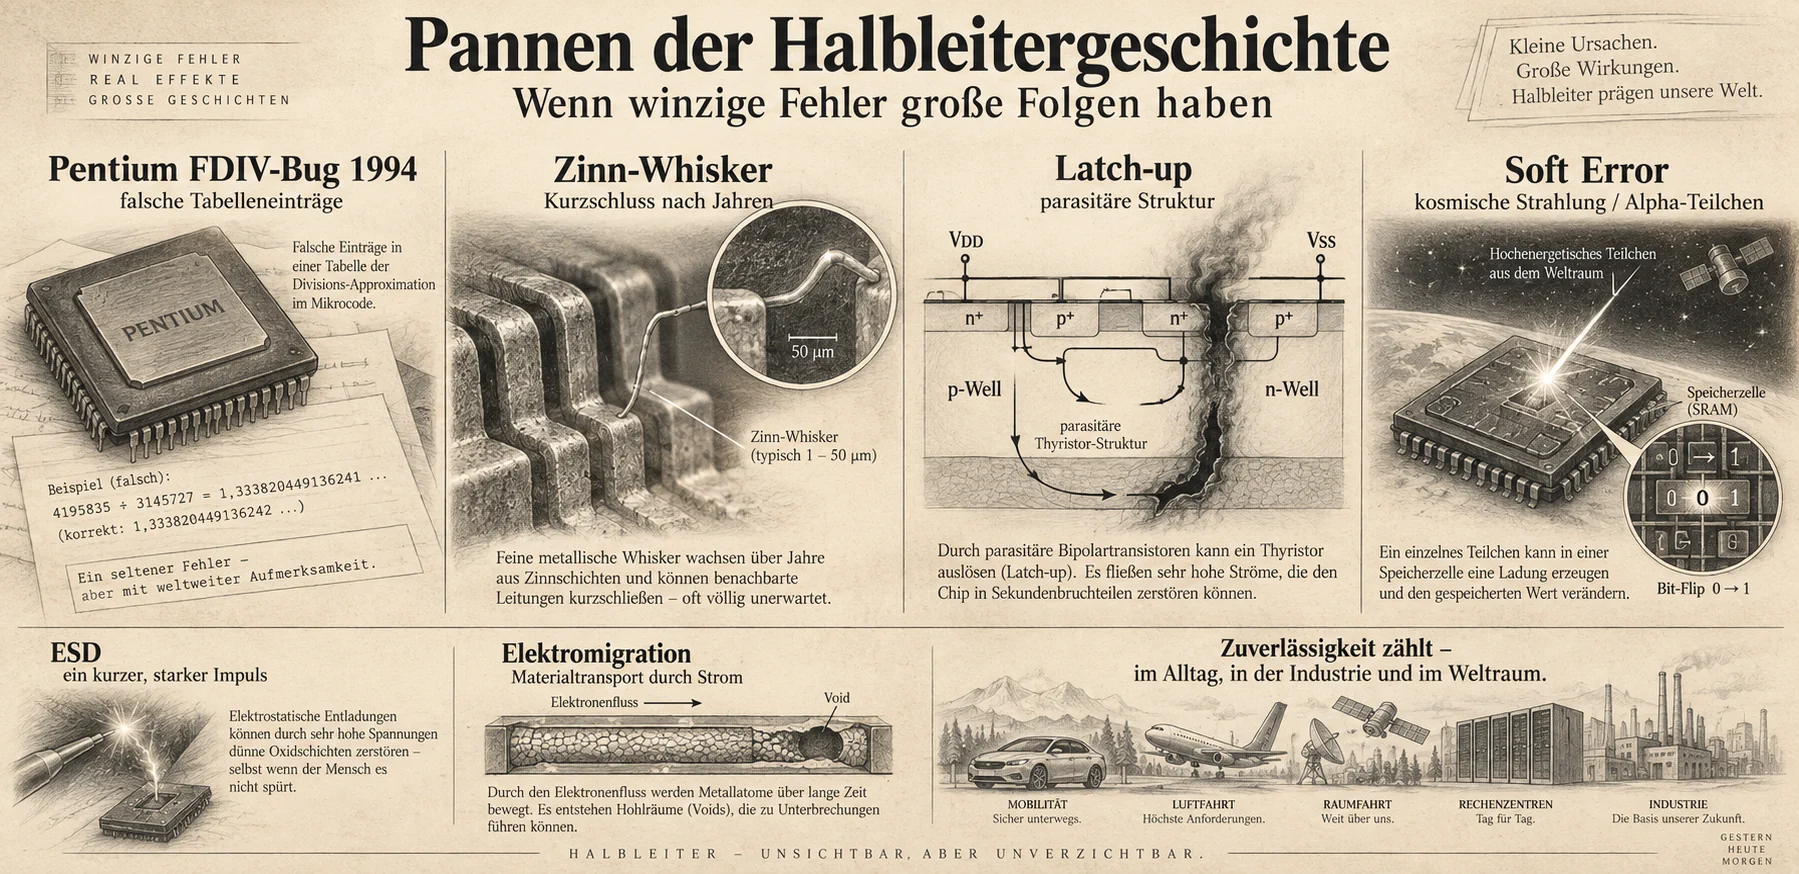
Bild: ChatGPT
Im Herbst 1994 rechnete der amerikanische Mathematikprofessor Thomas Nicely mit einem neuen Pentium-PC. Er untersuchte Zahlenreihen und stieß dabei auf ein merkwürdiges Ergebnis: Einige Divisionen lieferten nicht die Genauigkeit, die der Prozessor eigentlich garantieren sollte. Der Computer stürzte nicht ab. Die Rechnung lief durch, das Ergebnis sah plausibel aus – und war dennoch falsch. In einer Branche, die Milliarden Transistoren mit größter Präzision fertigt, hatten wenige fehlerhafte Einträge in einer internen Rechentabelle einen millionenschweren Rückruf ausgelöst.
Doch nicht jede spektakuläre Elektronikpanne beginnt mit einem Entwurfsfehler. Manchmal wächst ein fast unsichtbarer Zinnfaden zwischen zwei Anschlüssen. Manchmal schaltet ein CMOS-Chip unbeabsichtigt eine parasitäre Thyristorstruktur ein und erhitzt sich innerhalb kürzester Zeit. Und manchmal genügt ein Teilchen aus der natürlichen Strahlungsumgebung, um eine gespeicherte Null in eine Eins zu verwandeln. Solche Vorgänge gehören zur Halbleitergeschichte, weil sie immer wieder dazu zwangen, Bauelemente, Fertigungsmaterialien, Prüfmethoden und ganze Systemarchitekturen neu zu denken.
Eine Unterscheidung ist dabei entscheidend: Ein Entwurfsfehler, ein Fertigungsdefekt, ein Alterungsmechanismus und ein zufälliger Soft Error sind nicht dasselbe. Einige Fehler sind von Anfang an im Chip vorhanden. Andere entstehen erst nach Jahren. Wieder andere beschädigen den Halbleiter überhaupt nicht, sondern verändern nur vorübergehend einen elektrischen Zustand. Ihre Gemeinsamkeit ist, dass die Folgen auf Systemebene weit größer sein können als die ursprüngliche Ursache.
Die ersten Jahrzehnte: Warum ein funktionierender Chip noch kein zuverlässiger Chip war
Als Transistoren in den 1950er-Jahren die Elektronenröhren zunehmend ersetzten, versprachen sie geringeren Stromverbrauch, kompaktere Bauformen und eine höhere Zuverlässigkeit. Dennoch erwiesen sich auch die neuen Bauelemente als empfindlich. Unreine Kristalle, unkontrollierte Oberflächen, schlechte Kontaktierungen und unzureichend geschützte pn-Übergänge führten zu veränderten Kennlinien oder vollständigen Ausfällen. Ein einzelner Transistor konnte im Labor korrekt funktionieren, ohne sich in großen Stückzahlen stabil produzieren zu lassen.
Mit der Planartechnik, der Oxidpassivierung und der zunehmenden Automatisierung wurden viele dieser Schwierigkeiten beherrschbar. Gleichzeitig entstanden neue Risiken: Immer dünnere Oxidschichten, feinere Metallleitungen und dichter gepackte Speicherzellen reagierten empfindlicher auf Belastungen, die früher kaum auffielen. Zuverlässigkeit wurde deshalb zu einer eigenen Ingenieurdisziplin. Hersteller testeten nicht mehr nur, ob eine Schaltung funktionierte, sondern auch, wie sie sich unter Temperatur, Feuchtigkeit, elektrischer Überlast und über Tausende Betriebsstunden verhielt.
Schon damals zeigte sich ein Grundsatz, der bis heute gilt: In einer hochintegrierten Schaltung können mechanische, chemische, elektrische und logische Probleme ineinandergreifen. Deshalb ist die genaue Fehleranalyse mindestens so wichtig wie die Beobachtung, dass ein Gerät ausgefallen ist.
1960er-Jahre: Wenn Metallbahnen langsam verschwinden
Ein besonders tückischer Alterungsmechanismus ist die Elektromigration. Fließt eine hohe Stromdichte durch eine dünne Metallleitung, übertragen Elektronen Impuls auf Metallatome. Über lange Zeit können sich Atome dadurch verschieben. An einer Stelle entstehen Fehlstellen und schließlich ein Hohlraum, an anderer Stelle sammelt sich Material an. Eine Leiterbahn kann dadurch unterbrochen werden; Ablagerungen können unter ungünstigen Bedingungen Kurzschlüsse begünstigen.
Die physikalische Erscheinung war bereits früher bekannt, doch für integrierte Schaltungen wurde sie mit den immer feineren Metallstrukturen besonders relevant. James R. Black untersuchte in den 1960er-Jahren entsprechende Ausfallmechanismen und veröffentlichte 1969 grundlegende Arbeiten zum Zusammenhang zwischen Stromdichte, Temperatur und Lebensdauer dünner Metallfilme. Aus diesen Untersuchungen entwickelte sich die Verwendung beschleunigter Lebensdauertests und von Modellen, die für das heutige Verdrahtungsdesign unverzichtbar sind.
Das Bemerkenswerte: Ein Chip mit einer gefährdeten Leitung besteht zunächst möglicherweise jeden elektrischen Funktionstest. Erst viele Betriebsstunden später öffnet sich die Verbindung. Elektromigration ist deshalb keine einzelne historische Rückrufaktion, sondern eine ganze Klasse von Feldfehlern, die von der frühen integrierten Schaltung bis zu modernen Hochleistungsprozessoren ständig berücksichtigt werden muss.
1970er-Jahre: Ein unsichtbarer Strompfad im CMOS-Chip
Mit dem Aufstieg der CMOS-Technologie entstand ein weiterer Fehlermechanismus, der zunächst fast widersinnig erscheint. CMOS-Schaltungen bestehen aus komplementären n- und p-Kanal-MOSFETs. Die gewollten Transistoren sollen möglichst nur die benötigten Ströme führen. Innerhalb der Halbleiterstruktur entstehen durch die Anordnung von n-Wannen, p-Substrat und dotierten Anschlussgebieten jedoch zwangsläufig auch parasitäre Bipolartransistoren.
Diese parasitären npn- und pnp-Strukturen können sich gegenseitig so beeinflussen, dass sie zusammen wie ein Thyristor mit vier abwechselnd dotierten Bereichen wirken. Normalerweise ist die Anordnung inaktiv. Ein Spannungssprung, ein Überschwingen am Eingang, eingespritzte Ladung oder eine andere elektrische Störung kann sie aber zünden. Dadurch entsteht ein niederohmiger Pfad zwischen Versorgungsspannung und Masse: der sogenannte Latch-up.
Anders als bei einem kurzen Störimpuls endet der Stromfluss nicht unbedingt, wenn der ursprüngliche Auslöser verschwindet. Die beiden parasitären Transistoren halten sich gegenseitig leitend. Solange die Versorgung den erforderlichen Haltestrom bereitstellt, kann die Struktur eingeschaltet bleiben. Die Folgen reichen von einem erhöhten Versorgungsstrom über lokale Überhitzung bis zur dauerhaften Zerstörung des Chips.
Die CMOS-Industrie reagierte mit geeigneten Wannen- und Substratkontakten, Guard-Rings, kontrollierten Widerständen im Substrat, größerem Abstand kritischer Gebiete und gezielten Latch-up-Prüfungen. Später halfen auch andere Substrat- und Isolationskonzepte. Latch-up wurde dadurch nicht zu einer einzigen berühmten Panne, sondern zu einem grundlegenden Entwurfsrisiko, das in modernen Zuverlässigkeitsstandards ausdrücklich geprüft wird.
1978/1979: Der Speicherfehler kommt aus dem Gehäuse
In den 1970er-Jahren wuchs die Speicherdichte von DRAMs rasch. Die in jeder Speicherzelle gespeicherte elektrische Ladung wurde dabei kleiner. Ingenieure beobachteten gelegentlich falsche Bits, obwohl die Speicherzellen nach einer erneuten Beschreibung wieder normal funktionierten. Diese Fehler unterschieden sich von defekten Transistoren und unterbrochenen Leiterbahnen: Es war der gespeicherte Zustand verändert worden, nicht notwendigerweise das Bauelement.
Timothy C. May und Murray H. Woods von Intel beschrieben 1979 einen überraschenden Auslöser: Alphateilchen aus Spuren natürlich radioaktiver Stoffe in Gehäusematerialien. Uran und Thorium können selbst in sehr geringen Konzentrationen in verwendeten Materialien vorkommen. Zerfällt ein entsprechendes Atom, kann ein Alphateilchen in das Silicium eindringen und entlang seiner Bahn zahlreiche Elektron-Loch-Paare erzeugen. Gelangt genügend Ladung an einen empfindlichen Speicherknoten, kippt dessen logischer Zustand.
Solche Ereignisse heißen Soft Errors, weil sie zunächst keine bleibende Beschädigung hinterlassen. Die Zelle lässt sich wieder beschreiben, der Fehler kann aber trotzdem erhebliche Folgen haben: Ein falsches Bit in einer Berechnung, einem Dateisystem oder einer Steuerung kann zu fehlerhaften Ergebnissen oder einem Systemabsturz führen. Die Industrie begann daher, Verpackungsmaterialien hinsichtlich ihrer Strahlungsemission sorgfältiger auszuwählen und empfindliche Speicher besser abzusichern.
Die Pointe dieser Geschichte ist besonders aufschlussreich: Ein Halbleiter kann perfekte Fertigungsstrukturen besitzen und dennoch durch ein scheinbar nebensächliches Material außerhalb des eigentlichen Chips unzuverlässig werden.
1979: Auch kosmische Strahlung erreicht den Computer
Eine zweite Quelle von Soft Errors befindet sich nicht im Chipgehäuse, sondern über unseren Köpfen. Hochenergetische Teilchen aus dem Weltraum treffen auf die Erdatmosphäre und erzeugen dort Schauer sekundärer Teilchen. Ein Teil davon, insbesondere Neutronen, erreicht auch die Erdoberfläche. Wechselwirken solche Teilchen mit Atomkernen im Halbleiter, können wiederum geladene Reaktionsprodukte entstehen, die empfindliche Schaltungsknoten beeinflussen.
James F. Ziegler und W. A. Lanford zeigten 1979 in einer vielbeachteten Veröffentlichung, dass kosmische Strahlung für Halbleiterspeicher ein realer Zuverlässigkeitsfaktor sein kann. Sie untersuchten nicht nur die Teilchenwechselwirkungen im Silicium, sondern auch die Abhängigkeit von Abschirmung, Höhe über dem Meeresspiegel und Sonnenaktivität. Für die immer dichter werdenden Speicher wurde die zuvor unscheinbare natürliche Strahlungsumgebung zunehmend relevant.
Dabei dürfen zwei Mechanismen nicht verwechselt werden: Die von May und Woods beschriebenen Alphateilchen entstehen beispielsweise durch radioaktive Spuren in Verpackungsmaterialien; die von Ziegler und Lanford untersuchten kosmisch verursachten Fehler hängen vor allem mit Teilchen aus der atmosphärischen Strahlungskaskade zusammen. Beides kann zu einem Bitflip führen, aber Herkunft, Energieverteilung und Maßnahmen unterscheiden sich.
Warum aus einem Bitflip ein großer Systemfehler werden kann
Ein einzelner geänderter Speicherinhalt klingt harmlos. Entscheidend ist jedoch, welche Information an dieser Stelle steht. Ein gekipptes Bit in einem ungenutzten Speicherbereich bleibt womöglich unbemerkt. Wird dagegen ein Befehlswort, eine Speicheradresse oder ein sicherheitsrelevanter Parameter verändert, kann die Auswirkung erheblich sein.
In Raumfahrtanwendungen kommen zusätzliche Strahlungsquellen und höhere Teilchenenergien hinzu. Neben einzelnen Bitwechseln (Single Event Upsets, SEU) können kurzzeitige Störimpulse (Single Event Transients, SET) oder Störungen ganzer Funktionsblöcke auftreten. Manche Strahlungsereignisse können auch Latch-up auslösen; ein solcher Single Event Latch-up ist unter Umständen zerstörend und deshalb etwas grundlegend anderes als ein korrigierbarer Soft Error.
Als Gegenmaßnahmen entwickelten sich Fehlererkennung und -korrektur, insbesondere ECC-Speicher, periodisches Überprüfen und Korrigieren von Daten (Scrubbing), Redundanz, Schutzschaltungen und Strahlungsqualifikation. Einfache ECC-Verfahren können einzelne Bitfehler korrigieren, aber nicht beliebige Mehrfachfehler. Die passende Absicherung hängt daher von Anwendung, Bauelement und erwarteter Fehlerumgebung ab.
Wichtig ist auch die umgekehrte Schlussfolgerung: Nicht jeder unerklärliche Computerabsturz ist durch kosmische Strahlung verursacht. Solche Ursachen lassen sich ohne Messdaten, geeignete Untersuchungen oder statistische Auswertung oft gar nicht eindeutig nachweisen.
Zinn-Whisker: Metallfäden, die aus dem Nichts zu wachsen scheinen
Während sich bei einem Soft Error lediglich ein elektrischer Zustand ändert, können Zinn-Whisker einen echten elektrischen Kurzschluss auslösen. Dabei wachsen aus bestimmten Zinnoberflächen unter geeigneten Bedingungen haarfeine metallische Einkristalle. Sie sind häufig nur wenige Mikrometer dick, können aber eine Länge von mehreren Millimetern erreichen. Treffen sie auf einen benachbarten Anschluss oder Leiter, entsteht eine ungewollte leitende Verbindung.
Zinn-Whisker sind keine Siliciumkristalle, keine Bondingdrähte und auch keine absichtlich gewachsenen Strukturen. Sie bilden sich auf metallischen Oberflächen, etwa auf verzinnten Anschlussbeinen, Kontakten oder Relais. Mechanische Spannungen innerhalb der Zinnschicht sind ein wichtiger Einflussfaktor; die genaue Bildung hängt jedoch von Material, Beschichtung, Untergrund und Einsatzbedingungen ab. Ein Bauteil kann deshalb bei Auslieferung völlig unauffällig sein und erst viel später einen Fehler entwickeln.
Das Phänomen war schon seit der Mitte des 20. Jahrhunderts bekannt. Dennoch blieb es schwer vollständig zu beherrschen. Zinn-Blei-Legierungen können die Neigung zur Whiskerbildung deutlich verringern, während reine Zinnoberflächen als besonders kritisch gelten. Mit dem späteren Übergang zu bleifreien Werkstoffen gewann das Problem erneut Aufmerksamkeit; es ist aber keineswegs erst durch die Einführung bleifreier Elektronik entstanden.
Vom mikroskopischen Faden zum Satellitenausfall
Besonders eindrücklich ist die Sammlung von Ausfallberichten, die die NASA zu Zinn-Whiskern veröffentlicht hat. Sie dokumentiert Fehler in industriellen, militärischen und raumfahrttechnischen Anlagen. Bei mehreren kommerziellen Kommunikationssatelliten werden Ausfälle von Steuerprozessoren auf mutmaßliche Kurzschlüsse durch Zinn-Whisker an verzinnten Relaiskontakten zurückgeführt.
Ein Beispiel ist Galaxy VII: Nach einem Ausfall des ersten Steuerprozessors im Juni 1998 fiel im November 2000 auch der redundante Prozessor aus. Die NASA führt den Satelliten unter den Fällen auf, deren Ausfallursache mit Zinn-Whiskern in Verbindung gebracht wird. Die genaue Ursachenfeststellung auf einem nicht mehr zugänglichen Satelliten bleibt allerdings eingeschränkter als bei einer im Labor zerlegten Baugruppe.
Auch Galaxy IV, dessen Ausfall im Mai 1998 zahlreiche Pager-Verbindungen in den USA beeinträchtigte, wird häufig in diesem Zusammenhang genannt. Gerade hier ist Vorsicht nötig: Die NASA kennzeichnet den ersten Prozessorausfall ausdrücklich als nicht durch Whisker verursacht; darüber hinaus wurden für den Satellitenausfall auch andere Erklärungen, unter anderem Weltraumwetter, diskutiert. Eine eindeutige Zuschreibung des gesamten Vorfalls an Zinn-Whisker wäre deshalb unseriös.
Unstrittig ist die allgemeine Gefahr. Ein metallischer Faden kann in einer niedrig bestromten Schaltung dauerhaft zwei Kontakte überbrücken. Bei höherer Energie sind auch kurzzeitige Lichtbögen möglich. Gerade langlebige Satelliten und andere kaum wartbare Anlagen benötigen deshalb besonders strenge Werkstoffvorgaben. Die NASA untersagt reine Zinnoberflächen für zahlreiche kritische elektronische Bauteile ausdrücklich.
Ein Elektronikfehler nach rund 20 Jahren
Wie langsam solche Schäden entstehen können, zeigt ein weiteres von der NASA dokumentiertes Beispiel aus der Elektrizitätswirtschaft. Eine elektronische Baugruppe war ungefähr 1983 in Betrieb genommen worden. Erst um 2002 kam es zu einem Fehler, nachdem ein Zinn-Whisker zwei benachbarte Anschlussbeine eines integrierten Schaltkreises verbunden hatte. Die überbrückte Strecke betrug ungefähr 0,75 bis 1,0 Millimeter.
Die anschließende Untersuchung zeigte zahlreiche weitere Whisker an den Kontakten. Unklar blieb, ob sie über den gesamten Zeitraum langsam gewachsen waren oder ihr Wachstum lange geruht hatte. Für die Zuverlässigkeitstechnik war die Lehre dennoch eindeutig: Ein erfolgreicher Endtest und sogar viele störungsfreie Betriebsjahre garantieren nicht, dass ein mechanisch-chemischer Alterungsmechanismus ausgeschaltet ist.
Damit unterscheiden sich Whisker grundlegend vom Pentium-FDIV-Fehler. Beim Pentium war eine bestimmte Berechnung auf den betroffenen Chips von Anfang an fehlerhaft. Beim Whisker kann das Produkt jahrzehntelang völlig korrekt arbeiten, bevor erst ein zufälliger metallischer Kontakt entsteht.
1994: Ein Mathematiker entlarvt den Pentium
Zurück zum wohl bekanntesten einzelnen Prozessorfehler der PC-Geschichte: Thomas Nicely untersuchte 1994 mathematische Zahlenreihen, als er Inkonsistenzen auf einem Pentium-Rechner bemerkte. Nach systematischen Vergleichen mit anderen Maschinen ließ sich die Abweichung auf bestimmte Gleitkommadivisionen zurückführen. Andere Forscher bestätigten den Fehler, und die Nachricht verbreitete sich über frühe Internetforen und die Fachpresse.
Die Ursache lag nicht in fehlerhaftem Silicium, Staub auf dem Wafer oder einer beschädigten Recheneinheit. Der Pentium verwendete intern ein beschleunigtes Divisionsverfahren, bei dem aus einer Tabelle geeignete Werte für die nächsten Rechenschritte ausgewählt wurden. In den betroffenen Prozessoren fehlten fünf relevante Tabelleneinträge beziehungsweise enthielten falsche Werte. Bei bestimmten Operandenfolgen konnte der Prozessor deshalb falsche Ergebnisse erzeugen.
Der Fehler wurde als FDIV-Bug bekannt, benannt nach dem Gleitkomma-Divisionsbefehl der x86-Architektur. Nicht jede Division war betroffen; viele Anwender hätten die Abweichung im Alltag niemals bemerkt. Das eigentliche Problem war jedoch, dass eine auf mathematische Korrektheit angewiesene Anwendung unter bestimmten Bedingungen ein falsches Ergebnis erhalten konnte, ohne dass der Prozessor eine Fehlermeldung ausgab.
Die öffentliche Reaktion fiel deutlich stärker aus, als Intel zunächst erwartet hatte. Das Unternehmen hatte die Bedeutung des Fehlers anfangs aus der Perspektive der statistischen Häufigkeit bewertet. Für Kunden ging es dagegen auch um Vertrauen: Ein Prozessor sollte unabhängig vom Anwendungsfall korrekte Rechnungen liefern. Nach erheblichem Druck änderte Intel im Dezember 1994 seine Austauschpolitik und bot Besitzern betroffener Prozessoren einen Ersatz auf Anfrage an.
475 Millionen US-Dollar für fünf fehlerhafte Einträge
In seinem Geschäftsbericht für 1994 wies Intel eine Belastung von 475 Millionen US-Dollar aus, die vor allem Ersatzprozessoren, Material und Bestandsabschreibungen im Zusammenhang mit dem FDIV-Problem abdeckte. Damit wurde ein mikroskopisch kleiner Teil des Entwurfs zu einem wirtschaftlichen Ereignis von außergewöhnlichem Ausmaß.
Der Fall gilt als Wendepunkt im öffentlichen Umgang mit Prozessorfehlern. Er machte deutlich, dass auch hochentwickelte Fertigungsprozesse einen Fehler im logischen Entwurf perfekt millionenfach reproduzieren können. Genau darin liegt die Besonderheit einer Design-Panne: Je besser die Produktion läuft, desto mehr fehlerhafte Exemplare entstehen möglicherweise, bevor das Problem entdeckt wird.
Für die Halbleiterhersteller gewann die systematische Verifikation dadurch weiter an Bedeutung. Testvektoren, mathematische Referenzmodelle, Simulation, formale Methoden und die nachvollziehbare Kommunikation von sogenannten Errata sind wichtige Bestandteile moderner Prozessorentwicklung. Kein Prüfverfahren ist jedoch eine absolute Garantie dafür, dass jede denkbare Kombination aus Zuständen und Eingaben bereits untersucht wurde.
1997: Eine ungültige Instruktion legt den Rechner lahm
Einige Jahre später zeigte ein weiterer Pentium-Fehler eine andere Art von Entwurfsrisiko. Der als F00F-Bug bekannt gewordene Fehler wurde 1997 öffentlich. Eine bestimmte Folge von Maschinenbefehlsbytes konnte den Prozessor in einen Zustand bringen, in dem er nicht mehr normal reagierte. Ein Neustart war erforderlich, um das System wieder nutzbar zu machen.
Anders als beim FDIV-Bug ging es nicht um eine seltene numerische Abweichung, sondern um die fehlerhafte Behandlung einer ungültigen Instruktion. Besonders problematisch war, dass sich der Zustand aus nicht privilegiertem Programmcode auslösen ließ. Damit wurde ein Mikroarchitekturfehler unmittelbar zu einem Problem für die Stabilität und Sicherheit ganzer Betriebssysteme.
Softwareseitige Umgehungen und spätere Hardwarekorrekturen verhinderten die weitere Ausnutzung. Der Fall verdeutlicht, dass die Grenzen zwischen Hardware und Software keineswegs scharf sind: Ein falsches Verhalten eines Chips kann sich als Absturz eines vollständigen Computers zeigen, während eine geeignete Betriebssystemänderung die Auswirkungen reduzieren kann.
2011: Ein fehlerhafter Chipsatz und 733 Millionen US-Dollar
2011 traf eine andere Panne den PC-Markt. Intel identifizierte in der 6 Series Express-Chipsatzfamilie, bekannt unter dem Entwicklungsnamen Cougar Point, ein Entwurfsproblem. Es betraf bestimmte SATA-Verbindungen zur Anbindung von Laufwerken und konnte deren Zuverlässigkeit im Betrieb verschlechtern. Die Prozessor-Rechenkerne selbst waren nicht die Ursache; problematisch war eine Funktion im zugehörigen Chipsatz.
Intel stoppte die Auslieferung der betroffenen Versionen, änderte das Siliciumdesign und lieferte ab Februar 2011 korrigierte Chips. In seinem Geschäftsbericht bezifferte das Unternehmen die Kosten für Reparatur und Ersatz betroffener Materialien und Systeme schließlich auf rund 733 Millionen US-Dollar. Dies ist ein weiteres Beispiel für die enorme wirtschaftliche Wirkung eines Fehlerbilds, das von einzelnen Struktureigenschaften oder Schaltungsdetails in einem ansonsten komplexen Produkt abhängt.
Aus Sicht der Fabrik ist die Lehre dieselbe wie 1994: Ein Fehler kann die elektrische Erprobung einer ersten Charge überstehen und erst unter bestimmten Betriebsbedingungen oder nach einiger Zeit sichtbar werden. Deshalb müssen nicht nur Fertigungsfehler, sondern auch langfristige Funktions- und Lebensdauerannahmen geprüft werden.
ESD, beschädigte Oxide und verborgene Vorschäden
Nicht jede Panne lässt sich mit einem Jahresdatum verbinden. Zu den alltäglichen Gefahren der Halbleiterproduktion gehören elektrostatische Entladungen (ESD). Eine für den Menschen kaum bemerkbare Entladung kann an einem empfindlichen Eingang eine sehr hohe elektrische Feldstärke erzeugen. Dadurch können dünne Gateoxide beschädigt, pn-Übergänge überlastet oder Leiterbahnen lokal erhitzt werden.
Manchmal führt das sofort zum Ausfall. In anderen Fällen bleiben nur vorgeschädigte Strukturen zurück, die zunächst noch funktionieren, jedoch geringere Sicherheitsreserven haben. Einen späteren Ausfall im Feld dann eindeutig dem ursprünglichen ESD-Ereignis zuzuordnen, kann schwierig sein. Schutzmaßnahmen reichen von geeigneten Eingangsschaltungen über geerdete Arbeitsplätze und leitfähige Verpackungen bis zu geregelten Handhabungsprozessen.
Daneben verändern sich auch Isolatoren im Dauerbetrieb. Hohe elektrische Felder können die Defektbildung in dünnen Oxiden beschleunigen, bis die Isolation versagt. Bei MOS-Transistoren führen unter anderem Bias Temperature Instability (BTI) und andere Alterungseffekte zu Änderungen der Schwellspannung. Ein Bauelement muss daher nicht nur heute die Spezifikation erfüllen, sondern trotz prognostizierter Alterung lange genug innerhalb der vorgesehenen Grenzen bleiben.
Warum selbst perfekte Reinräume diese Pannen nicht verhindern
Reinräume reduzieren Partikel und chemische Verunreinigungen; moderne Prüfverfahren entdecken zahlreiche Herstellungsfehler. Trotzdem können sie nicht jede Ursache beseitigen. Der FDIV-Bug lag im Entwurf und wurde durch saubere Fertigung nicht besser. Ein Zinn-Whisker wächst möglicherweise erst lange nach der Auslieferung. Ein Soft Error kann durch ein Teilchen aus der natürlichen Strahlungsumgebung ausgelöst werden. Und Latch-up entsteht aus parasitären Strukturen, die im normalen CMOS-Prozess physikalisch vorhanden sind.
Deshalb entwickelten Halbleiterhersteller mehrere, ineinandergreifende Zuverlässigkeitsstrategien. Design for Reliability betrachtet Risiken schon bei der Schaltungsentwicklung. Prozessüberwachung, Burn-in- und Stresstests sollen frühe Fertigungsfehler und Alterungsmechanismen sichtbar machen. Die physikalische Fehleranalyse lokalisiert Ausfallstellen mit Mikroskopie, elektrischen Messverfahren, Wärmebildern und Querschliffen. Auf Systemebene ergänzen ECC, Watchdogs, Redundanz und Fehlertoleranzmaßnahmen die Grenzen des einzelnen Chips.
Der Erfolg solcher Maßnahmen ist groß: Moderne Elektronik arbeitet in den meisten Anwendungen über viele Jahre erstaunlich zuverlässig. Die zahlreichen bekannten Pannen zeigen daher nicht, dass die Halbleitertechnik grundsätzlich unzuverlässig wäre. Sie zeigen vielmehr, wie aufwendig es ist, Zuverlässigkeit über Milliarden identischer Bauelemente, verschiedene Einsatzorte und viele Betriebsjahre hinweg sicherzustellen.
Was die Pannen gemeinsam haben – und worin sie sich unterscheiden
Betrachtet man die Fälle nebeneinander, entstehen vier klar unterschiedliche Fehlerklassen:
- Entwurfsfehler: Der Pentium-FDIV-Bug, der F00F-Bug und der Chipsatzfehler von 2011 beruhten auf Eigenschaften des digitalen oder analogen Entwurfs. Die betroffenen Chips konnten exakt nach Vorgabe gefertigt und dennoch falsch sein.
- Strukturelle Schwachstellen: CMOS-Latch-up ist auf parasitäre Halbleiterstrukturen zurückzuführen. Ob es tatsächlich zu einer Störung kommt, hängt von Layout, Schutzmaßnahmen und Auslösebedingungen ab.
- Material- und Alterungsfehler: Elektromigration, dielektrischer Verschleiß und Zinn-Whisker können sich über längere Zeit entwickeln. Ein Gerät funktioniert zunächst und fällt möglicherweise erst später aus.
- Zufällige Strahlungseffekte: Soft Errors verändern Daten oder Zustände, ohne den Chip zwingend dauerhaft zu beschädigen. Sie werden eher durch geeignete Fehlertoleranz als durch eine vollständige Beseitigung jeder Strahlungsquelle beherrscht.
Die Zuordnung hilft auch bei der Fehlersuche. Ohne sie könnte man einen einmaligen Speicherbitfehler fälschlich als Defekt der Speicherzelle einstufen, einen systematischen Rechenfehler durch Austauschen der Platine beheben wollen oder einen alterungsbedingten Kontaktfehler übersehen, weil die Baugruppe einen kurzen Funktionstest besteht.
Die eigentliche Leistung: Aus Fehlern lernen
Die großen Pannen der Halbleitergeschichte erzählen nicht nur von beschädigten Bauteilen, falschen Ergebnissen und teuren Rückrufen. Sie erzählen davon, wie die Industrie lernte, Fehler überhaupt erst zu erkennen. Der Pentium-Fall machte die Bedeutung logischer Verifikation und öffentlicher Fehlerkommunikation sichtbar. Strahlungsbedingte Speicherfehler führten zur Verbesserung von Materialien und Fehlerschutzverfahren. Latch-up veränderte Layoutregeln und Teststandards. Zinn-Whisker beeinflussten Materialvorgaben für langlebige und sicherheitskritische Elektronik.
Die Entwicklung wird dabei nie endgültig abgeschlossen sein. Kleinere Strukturen, neue Materialien, 3D-Integration und komplexere Gehäuse eröffnen neue Möglichkeiten, aber auch neue Ausfallmechanismen. Selbst wenn einzelne Transistoren zuverlässiger werden, können Milliarden von ihnen und unzählige Wechselwirkungen ein Gesamtsystem schwieriger beherrschbar machen.
Das vielleicht wichtigste Vermächtnis dieser Pannen ist daher eine nüchterne Erkenntnis: Ein Chip ist nicht zuverlässig, weil er einmal korrekt funktioniert. Er ist zuverlässig, wenn seine Entwickler die möglichen Fehler verstehen, geeignete Grenzen festlegen und auch dann Vorsorge treffen, wenn nicht jede Ursache vollständig ausgeschlossen werden kann. So wurde die Halbleiterindustrie nicht trotz ihrer Pannen immer leistungsfähiger, sondern auch durch die Erkenntnisse, zu denen sie gezwungen wurde.
Quellen und weiterführende Literatur
- Rhode Island Computer Museum: Pentium Floating-Point FDIV Bug
- Intel: Historical Annual Reports, insbesondere Geschäftsbericht 1994
- Intel: Intel Identifies Chipset Design Error, Implementing Solution (2011)
- Intel: Annual Report 2011, Note 20 „Chipset Design Issue“
- NASA NEPP: Tin Whisker Failures, dokumentierte Satelliten- und Gerätefälle
- NASA NEPP: Basic Info on Tin Whiskers
- NASA NEPP: Tin Whisker Failure after Approximately 20 Years
- NASA: Pure Tin Plating Prohibition
- T. C. May und M. H. Woods: Alpha-particle-induced soft errors in dynamic memories (1979)
- J. F. Ziegler und W. A. Lanford: Effect of Cosmic Rays on Computer Memories (1979)
- IEEE Technology Navigator: Latch Up
- J. R. Black: Electromigration—A Brief Survey and Some Recent Results (1969)
- NASA: Reliability Handbook for Silicon Monolithic Microcircuits, Volume 2 (1969)