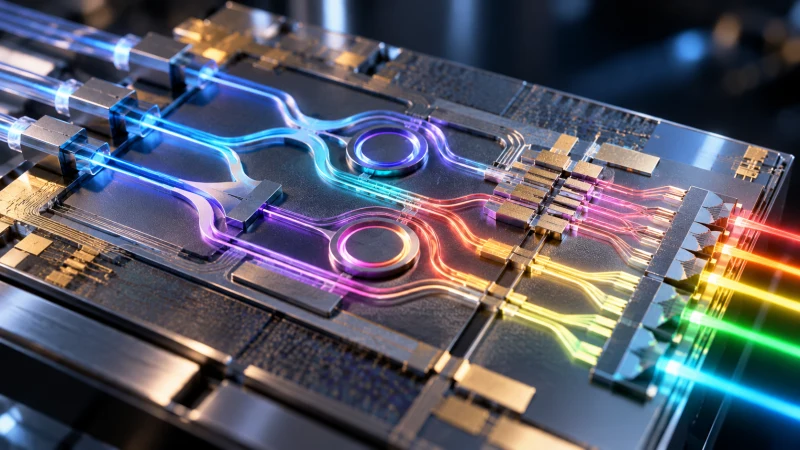
In großen AIartificial intelligence-Installationen entscheidet nicht mehr allein die Geschwindigkeit einzelner Rechenchips über die Gesamtleistung. Entscheidend ist auch, wie schnell Daten aus Speicher und Netzwerk zu den GPUgraphics processing unitEin Grafikprozessor, der auch als Beschleuniger für KI-Workloads eingesetzt wird.s gelangen und wie effizient die Systeme untereinander kommunizieren. Genau an diesem Punkt setzen Silicon Photonics und Co-Packaged Optics (CPOco-packaged opticsOptische Bauelemente werden direkt mit dem Prozessor in einem Package integriert) an: Beide Ansätze verlagern einen Teil der Datenübertragung von elektrischen Leitungen hin zu Licht.
GPUgraphics processing unitEin Grafikprozessor, der auch als Beschleuniger für KI-Workloads eingesetzt wird.s können ihre Rechenleistung erst ausspielen, wenn Trainingsdaten, Modellgewichte und Zwischenergebnisse rechtzeitig ankommen. Bei großen Modellen müssen viele GPUgraphics processing unitEin Grafikprozessor, der auch als Beschleuniger für KI-Workloads eingesetzt wird.s zudem laufend Resultate austauschen. Werden die Datenpfade zu schmal, warten die Recheneinheiten trotz hoher Spitzenleistung auf Nachschub. Mit steigenden Chip- und Portgeschwindigkeiten wächst daher die Bedeutung von Speicher- und Netzwerkpfaden im Gesamtsystem.
Kupfer bleibt für sehr kurze Strecken innerhalb von Chips und Gehäusen nützlich, stößt bei höheren Geschwindigkeiten und längeren Leitungen aber an Grenzen. Die Signale verlieren an Stärke, überlagern sich und müssen durch Repeater und Korrekturschaltungen wiederhergestellt werden. Das kostet zusätzliche Leistung und erhöht die Abwärme. Optische Verbindungen umgehen diesen Nachteil, weil ein einzelnes Faserpaar mehrere Wellenlängen gleichzeitig transportieren kann. Mit WDMwavelength division multiplexKenngröße für die zeitliche Änderung, Übertragung oder spektrale Eigenschaft eines Signals. lassen sich unterschiedliche Datenströme auf verschiedene Wellenlängen legen und so mehr Kapazität ohne zusätzliche Fasern erreichen.
Silicon Photonics bringt die dafür nötige Optik auf einen Chip. Wellenleiter führen das Licht per Totalreflexion, Modulatoren schreiben elektrische Informationen auf das Lichtsignal, und Photodetektoren wandeln es wieder zurück. Der Vorteil liegt nicht nur in der kompakten Bauform, sondern auch darin, dass sich Verfahren der Halbleiterfertigung für die präzise und skalierbare Herstellung solcher optischer Strukturen nutzen lassen. Da Silizium selbst Licht jedoch nicht effizient elektrisch erzeugt, kommen für Laser häufig Verbundhalbleiter wie InP zum Einsatz, etwa in Form externer Laserquellen.
CPOco-packaged opticsOptische Bauelemente werden direkt mit dem Prozessor in einem Package integriert rückt die optische Engine direkt neben den Switch-ASICapplication-specific integrated circuitelektronische Schaltung, die als integrierter Schaltkreis realisiert wurde auf einen gemeinsamen Package-Substratträger. Dadurch verkürzt sich der elektrische Weg zwischen Schalterchip und Optik deutlich, während die Faser den längeren Transport übernimmt. Gegenüber pluggable Modulen kann das die Bandbreitendichte erhöhen und die Leistung senken, die sonst für die Kompensation von Signalverlusten benötigt würde. Gleichzeitig verlangt das Konzept eine enge Ko-Entwicklung von Optik, Treibern, Gehäuse und Gesamtsystem.
Die technischen Hürden bleiben beträchtlich: Laserspeisung, exakte Faseranbindung, thermische Belastung durch benachbarte ASICapplication-specific integrated circuitelektronische Schaltung, die als integrierter Schaltkreis realisiert wurdes und die Ausbeute eines Pakets, in dem ein einzelner Defekt das Gesamtsystem beeinträchtigen kann. Entsprechend wird auch über Architekturen nachgedacht, die Fehler leichter erkennen und beheben lassen. Neben CPOco-packaged opticsOptische Bauelemente werden direkt mit dem Prozessor in einem Package integriert werden dafür auch LPO und NPO beschrieben, die jeweils andere Kompromisse zwischen Austauschbarkeit, Leistung und Integrationsgrad eingehen.
In den Tests, die im Text genannt werden, lag der Leistungsbedarf des optischen Interconnect-Teils eines CPOco-packaged opticsOptische Bauelemente werden direkt mit dem Prozessor in einem Package integriert-Switch-Systems um rund 65 Prozent unter dem einer vergleichbaren pluggable Architektur. Parallel bleibt HBM1. human body modelESD-Prüfmodell, das die elektrostatische Entladung einer Person in ein Bauelement nachbildet.2. High Bandwidth MemoryHBM ist ein gestapelter DRAM-Speicher mit sehr hoher Bandbreite für Rechenbeschleuniger. für kurze, breite Verbindungen direkt neben der GPUgraphics processing unitEin Grafikprozessor, der auch als Beschleuniger für KI-Workloads eingesetzt wird. wichtig, während CPOco-packaged opticsOptische Bauelemente werden direkt mit dem Prozessor in einem Package integriert die Kommunikation zwischen mehreren GPUgraphics processing unitEin Grafikprozessor, der auch als Beschleuniger für KI-Workloads eingesetzt wird.-Systemen adressiert. Ergänzend rückt auch CXLCompute Express LinkCXL ist eine Schnittstelle für kohärente Verbindungen zwischen Prozessoren, Speicher und Beschleunigern. mit Memory Pooling in den Blick, wenn verteilte Speicherressourcen effizienter genutzt werden sollen. Im Kern zielt die Entwicklung darauf, Rechen-, Speicher- und Netzwerkteile enger zusammenzuführen, damit AIartificial intelligence-Systeme nicht an ihren Datenwegen ausgebremst werden.